学习曲线何时遵循幂律?
发布时间:
论文(arXiv) · 代码(GitHub) · English
我们(部分地)给出了幂律 scaling law 成立的充要条件,指出 intrinsic time 以及 batch size 与 learning rate 的比值可以调控这些规律,并在 300M nano-GPT 的训练中成功预测了 loss 曲线。这也展示了一个简单模型如何为 LLM 预训练提供思路。
Scaling law 描述了语言模型的 loss 如何随模型规模、训练数据量和计算量变化。在许多实验中,这些关系可以用幂律近似描述。借助这些规律,我们可以估计扩大训练规模能带来多少收益,并在有限的计算预算下决定模型该做多大、该训练多少 token。
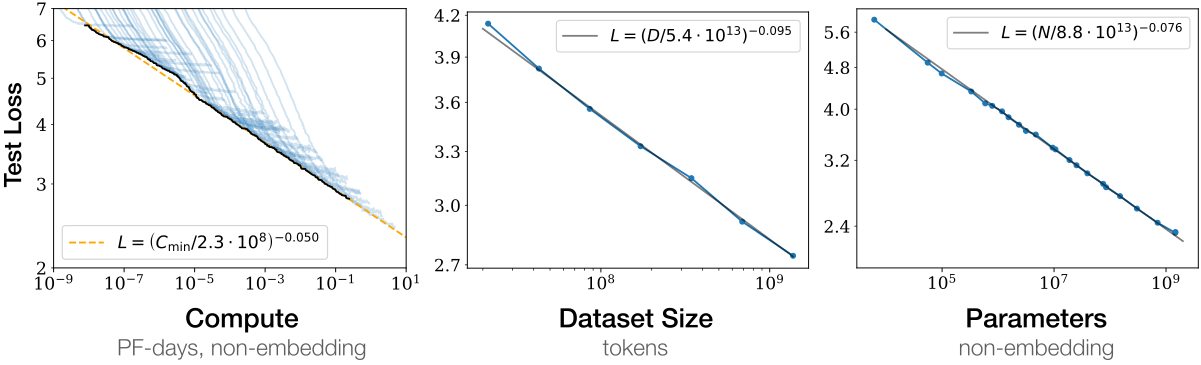
计算预算固定时,模型越大,能用于训练的 token 就越少。Chinchilla(Hoffmann et al. (2022)) 用幂律形式的 scaling law 拟合这种权衡:一个具有 \(N\) 个参数、训练了 \(D\) 个 token 的模型,其最终 loss 近似为
\[L(N,D)\approx L_\infty+\frac{A_N}{N^\alpha}+\frac{A_D}{D^\beta}.\]其中,\(L_\infty\) 是拟合得到的 loss floor。两个额外 loss 项都按幂律下降:模型规模项按 \(N^{-\alpha}\) 下降,训练 token 数项按 \(D^{-\beta}\) 下降,其中 \(A_N,A_D\) 是拟合幅度,\(\alpha,\beta\) 是拟合指数。
把拟合曲线延伸到已有观测范围之外很容易,难的是判断什么时候可以相信它。模型、数据和训练方案都可能改变这些规律。
在 Qiu et al. (2024) 的合成回归实验中,MLP 学习一个频率分布呈指数衰减的目标时,得到的 compute–loss frontier 无法用幂律很好地描述。训练方案同样重要。在 Porian et al. (2024) 的语言模型实验中,幂律在调优后的训练方案下能够较好地外推,但在其他方案下,外推效果明显变差。
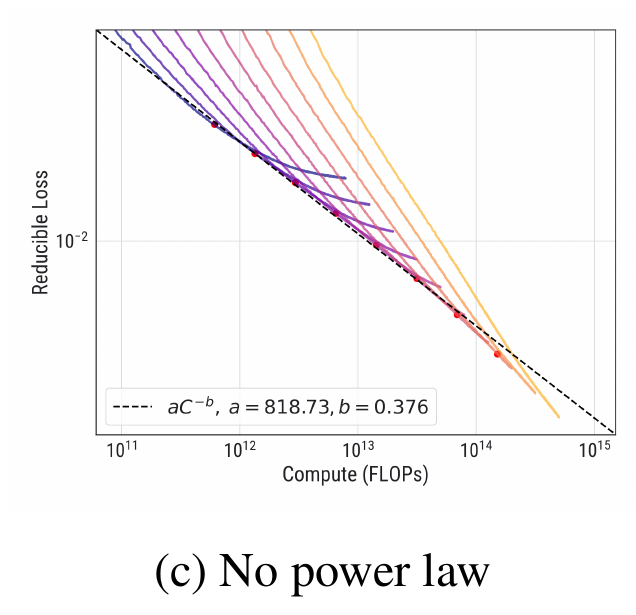
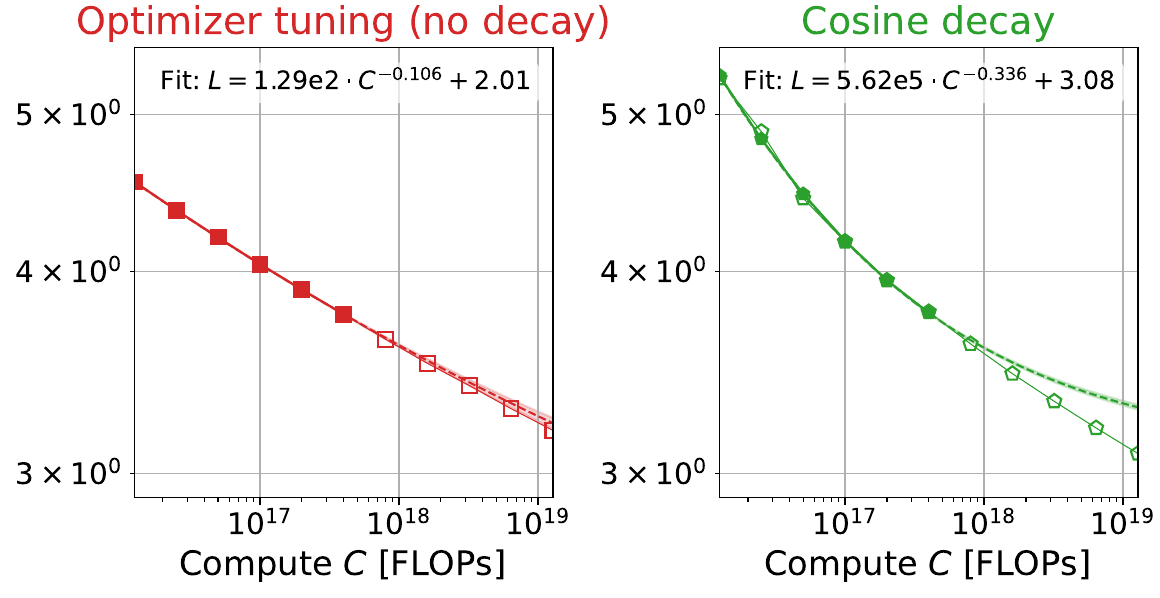
要理解这些 frontier 何时遵循幂律、何时不遵循,需要先看构成它们的单模型训练曲线:模型和数据固定后,loss 在什么条件下呈幂律下降,训练方式又怎样改变这一规律。
在某个训练阶段,loss 可以拟合为
\[L(t)\approx a\,t^{-p},\]其中,\(t\) 是训练步数,\(a\) 是拟合幅度,\(p\) 是这一阶段的下降指数。比较不同 learning-rate schedule 下的训练,就能看到训练方式如何影响 \(p\)。
Mircea et al. (2025) 比较了架构、数据和其他设置相同的两组独立训练:一组在 warmup 后使用 constant learning rate,另一组在 warmup 后使用 cosine decay。
比较两个面板中的 144M 模型:cosine decay 将训练后期的拟合指数从 0.023 提高到 0.036。拟合斜率不仅取决于模型和数据,也取决于训练 schedule。
这些例子把几个问题连在了一起:loss 何时呈幂律下降,幂律为什么会出现(Liu and Gore (2026)),以及数据与任务结构和训练 schedule 如何共同影响它的指数(Maloney et al. (2022))。要回答这些问题,我们从随机梯度下降(SGD)的更新过程看起。
SGD 会留下记忆
SGD 用 minibatch 估计梯度。与使用全梯度相比,采样误差会给参数带来随机扰动;后续更新从这些改变后的参数继续,因此,一次扰动对 loss 的影响可能持续多步。
对于模型 \(f_\theta\),设其训练目标为 \(\mathcal L\),记 \(\eta_t\) 为 learning rate,\(B_t\) 为 batch size,\(\xi_t\) 为 minibatch 梯度误差。每次使用新采样的独立同分布样本时,SGD 可写为
\[\theta_{t+1} =\theta_t-\eta_t\nabla\mathcal L(\theta_t)-\eta_t\xi_t, \qquad \mathbb E_t[\xi_t]=0, \qquad \operatorname{Cov}_t(\xi_t)=\frac{\Sigma(\theta_t)}{B_t}.\]这里的期望以训练历史为条件,\(\Sigma\) 是单样本梯度协方差。因此,参数扰动 \(-\eta_t\xi_t\) 的方差尺度为 \(\eta_t^2/B_t\):减小 learning rate 或增大 batch size,都能减小扰动。对于后续 loss 而言,关键是之后的更新如何传播这一扰动。
小噪声展开让我们可以把这些影响加起来。记 \(F(n)\) 为无噪声的 validation loss,\(K(n,s)\) 为在第 \(n\) 次更新时对第 \(s\) 次更新注入噪声的响应:
\[\mathbb E L_{\mathrm{val}}(\theta_n) \approx \underbrace{F(n)}_{\text{baseline learning}} +\sum_{s<n} \underbrace{\frac{\eta_s^2}{B_s}}_{\text{injected variance scale}} \underbrace{K(n,s)}_{\text{effect on the final loss}}.\]第一项对应从相同初始化出发、采用相同 learning-rate schedule 的全梯度更新;求和项汇总了 minibatch noise 的影响。这是 forcing–memory 分解的起点。
推导细节:从 SGD 更新到 memory response
固定更新步数 \(n\)、初始化 \(\theta_0\) 和确定性的 schedule \((\eta_t,B_t)\)。令 \(\theta_t\in\mathbb R^p\) 为第 \(t\) 次更新前的参数。每次更新都使用从同一数据分布中新采样的独立同分布样本。假设下述展开所需的光滑性条件和矩界成立。
1. 采样噪声的大小。 对于模型 \(f_\theta\) 和单样本 loss \(\ell(f_\theta;z)\),记 \(\mathcal L(\theta)=\mathbb E_z[\ell(f_\theta;z)]\),\(g(\theta;z)=\nabla_\theta\ell(f_\theta;z)\)。在第 \(t\) 次更新中,令 \(z_{t,i}\) 为该批次中的第 \(i\) 个样本。minibatch 梯度 \(\widehat g_t\) 及其采样误差 \(\xi_t\) 为
\[\widehat g_t=\frac1{B_t}\sum_{i=1}^{B_t}g(\theta_t;z_{t,i}), \qquad \xi_t=\widehat g_t-\nabla\mathcal L(\theta_t).\]令 \(\mathbb E_t\) 表示以训练历史为条件的期望,\(\mathbb E\) 表示对所有批次取期望。定义单样本梯度协方差 \(\Sigma(\theta)=\operatorname{Cov}_z(g(\theta;z))\)。由样本的条件独立性可得
\[\mathbb E_t[\xi_t]=0, \qquad \mathbb E_t[\xi_t\xi_t^{\!\top}] =\frac1{B_t^2}\sum_{i=1}^{B_t}\Sigma(\theta_t) =\frac{\Sigma(\theta_t)}{B_t}.\]参数扰动为 \(h_t=-\eta_t\xi_t\),因此 \(\mathbb E_t\lVert h_t\rVert^2=\eta_t^2\operatorname{Tr}\Sigma(\theta_t)/B_t\)。这样就把依赖 schedule 的方差尺度 \(\eta_t^2/B_t\) 与依赖状态的梯度协方差区分开来。
2. 单次扰动如何经过后续更新传播。 定义全梯度更新映射 \(D_t\) 及其参考轨迹 \(\bar\theta_t\):
\[D_t(\theta)=\theta-\eta_t\nabla\mathcal L(\theta), \qquad \bar\theta_{t+1}=D_t(\bar\theta_t), \qquad \bar\theta_0=\theta_0.\]将扰动 \(h_s=-\eta_s\xi_s\) 仅注入第 \(s\) 次更新,其余步骤均使用全梯度更新。令 \(\delta_t^{(s)}\) 为相对于 \(\bar\theta_t\) 的位移。若 Hessian 局部 Lipschitz 连续,将两条轨迹的更新相减,并对 \(t\ge s+1\) 展开,可得
\[\begin{aligned} \delta_{t+1}^{(s)} &=D_t(\bar\theta_t+\delta_t^{(s)})-D_t(\bar\theta_t)\\ &=\left[I-\eta_t\nabla^2\mathcal L(\bar\theta_t)\right]\delta_t^{(s)} +O\!\left(\eta_t\|\delta_t^{(s)}\|^2\right). \end{aligned}\]从 \(\delta_{s+1}^{(s)}=-\eta_s\xi_s\) 出发,仅保留线性项,得到
\[\delta_n^{(s)}\approx-\eta_s A_{n-1}\cdots A_{s+1}\xi_s, \qquad A_t=I-\eta_t\nabla^2\mathcal L(\bar\theta_t).\]这里的 \(A_t\) 是沿参考轨迹的更新 Jacobian。矩阵乘积描述了后续更新如何改变原始扰动;空乘积为 \(I\)。
3. 扰动如何改变最终 loss。 令 \(L_{\mathrm{val}}\) 为 validation loss。定义 \(G_{n,s}(\theta)\) 为从参数 \(\theta\) 出发、自第 \(s\) 次更新起完成其余全梯度更新后得到的最终 validation loss:
\[G_{n,s}(\theta) =L_{\mathrm{val}}\!\left((D_{n-1}\circ\cdots\circ D_s)(\theta)\right), \qquad G_{n,n}(\theta)=L_{\mathrm{val}}(\theta).\]根据定义,\(G_{n,s}=G_{n,s+1}\circ D_s\)。
记 \(\Psi=D_{n-1}\circ\cdots\circ D_{s+1}\) 为从第 \(s\) 次更新后的参数到最终参数的映射,其坐标分量为 \(\Psi_i\)。于是 \(G_{n,s+1}=L_{\mathrm{val}}\circ\Psi\),由二阶链式法则可得
\[\begin{aligned} \nabla^2G_{n,s+1}(\theta) ={}&\left[\frac{\partial\Psi}{\partial\theta}(\theta)\right]^{\!\top} \nabla^2L_{\mathrm{val}}(\Psi(\theta))\,\frac{\partial\Psi}{\partial\theta}(\theta)\\ &+\sum_{i=1}^{p} \partial_i L_{\mathrm{val}}(\Psi(\theta))\,\nabla^2\Psi_i(\theta). \end{aligned}\]从 \(\bar\theta_{s+1}\) 出发,完成其余更新后到达 \(\bar\theta_n\),且 \(\frac{\partial\Psi}{\partial\theta}\) 等于 \(A_{n-1}\cdots A_{s+1}\)。代入可得
\[\begin{aligned} \nabla^2G_{n,s+1}(\bar\theta_{s+1}) ={}&(A_{n-1}\cdots A_{s+1})^{\!\top} \nabla^2L_{\mathrm{val}}(\bar\theta_n) (A_{n-1}\cdots A_{s+1})\\ &+\sum_{i=1}^{p} \partial_i L_{\mathrm{val}}(\bar\theta_n)\,\nabla^2\Psi_i(\bar\theta_{s+1}). \end{aligned}\]传播矩阵由此进入未来 loss 的曲率。第一项衡量 loss 对最终参数离散程度的响应。第二项刻画非线性更新引起的参数均值偏移:均值为零的扰动经过非线性传播后,均值未必仍为零。两者都有二阶贡献,因此都必须保留。
回到实际的 SGD 轨迹,定义 \(\theta_s^+=D_s(\theta_s)\),即第 \(s\) 次更新中完成全梯度部分后的状态。由于 \(\theta_{s+1}=\theta_s^+ +h_s\),取条件期望的 Taylor 展开给出
\[\begin{aligned} &\mathbb E_s\!\left[G_{n,s+1}(\theta_s^+ +h_s)-G_{n,s+1}(\theta_s^+)\right]\\ &\quad=\frac12\mathbb E_s\!\left[ h_s^{\!\top}\nabla^2G_{n,s+1}(\theta_s^+)h_s\right] +O\!\left(\eta_s^3\mathbb E_s\|\xi_s\|^3\right)\\ &\quad=\frac{\eta_s^2}{2B_s}\operatorname{Tr}\!\left[ \Sigma(\theta_s)\nabla^2G_{n,s+1}(\theta_s^+) \right] +O\!\left(\eta_s^3\mathbb E_s\|\xi_s\|^3\right). \end{aligned}\]线性项因 \(\mathbb E_s[h_s]=0\) 而消失;第二个等号使用了 \(\mathbb E_s[h_sh_s^{\top}]=\eta_s^2\Sigma(\theta_s)/B_s\)。高阶余项由未来 loss 在从 \(\theta_s^+\) 到 \(\theta_s^+ +h_s\) 的线段上的三阶导数控制。
4. 汇总所有更新的影响。 通过望远镜求和,中间的未来 loss 值相互抵消,剩下最终 SGD loss 与无噪声 baseline 之差:
\[\begin{aligned} L_{\mathrm{val}}(\theta_n)-G_{n,0}(\theta_0) &=\sum_{s<n}\left[G_{n,s+1}(\theta_{s+1})-G_{n,s}(\theta_s)\right]\\ &=\sum_{s<n}\left[ G_{n,s+1}(\theta_s^+ +h_s)-G_{n,s+1}(\theta_s^+) \right]. \end{aligned}\]取期望,并定义无噪声 baseline \(F(n)=G_{n,0}(\theta_0)\) 及响应系数
\[K(n,s) :=\frac12\mathbb E\!\left[ \operatorname{Tr}\!\left( \Sigma(\theta_s)\nabla^2G_{n,s+1}(D_s(\theta_s)) \right)\right].\]令 \(\mathcal E_n\) 汇总所有更新中高阶余项的期望。代入第 3 步的展开式,得到
\[\mathbb E L_{\mathrm{val}}(\theta_n) =F(n) +\sum_{s<n}\frac{\eta_s^2}{B_s}K(n,s) +\mathcal E_n.\]这个计算并未去掉先前噪声的影响:\(\theta_s\) 本身已经依赖于此前的所有批次。因此,定义 \(K(n,s)\) 时取的平均也包含了先前噪声如何改变第 \(s\) 次更新所处状态的影响。
5. 近似留下的误差。 对于所考虑的采样历史,令 \(M_{n,s}\) 为各条 Taylor 展开线段上 \(|\nabla^3G_{n,s+1}|\) 的一致上界。则
\[|\mathcal E_n| \le\frac16\sum_{s<n} M_{n,s}\eta_s^3\mathbb E\|\xi_s\|^3.\]忽略 \(\mathcal E_n\),就得到正文中的响应近似。在固定更新步数下,若将采样噪声乘以 \(\epsilon\),则在导数和三阶矩具有一致界的条件下,保留项的主导贡献是 \(\epsilon\) 的二次项,而余项为 \(O(\epsilon^3)\)。
这个计算说明了 \(K(n,s)\) 衡量的是什么:第 \(s\) 次更新加入的噪声如何影响第 \(n\) 次更新的 loss,其中也包括训练过程中所处状态的影响。要用带正衰减指数的幂律描述这一响应随时间的变化,还需要进一步的建模。接下来的几节将解释谱模型如何产生这样的规律,以及 LLM 实验如何检验它能否预测新 schedule 下的 loss。
在我们的 Gaussian random feature model 中,特征固定、输出权重可训练,并使用 squared loss。SGD 相对于无噪声目标的期望平方预测误差 \(R_t\) 满足如下精确递推:
\[R_t=F_t+\sum_{s<t}K_{t,s}\bigl(R_s+\sigma^2\bigr).\]\(F_t\) 描述初始误差的传播,历史求和项描述训练噪声的累积影响。第 \(s\) 步的剩余预测误差 \(R_s\) 和 label noise 方差 \(\sigma^2\) 共同提供噪声来源,而 \(K_{t,s}\) 描述这些噪声对第 \(t\) 步 loss 的影响。
bias–variance 提供了对同一动力学的另一种分组方式。考虑模型能够表示无噪声目标的情形,并假设 label noise 独立于输入且均值为零。沿用 Zou et al. (2021) 按误差来源作出的分解,用 \(B_t\) 表示 clean-label SGD 所产生的误差,用 \(V_t\) 表示从零初始误差出发、由 label noise 驱动的误差。仅在这段比较中,\(B_t\) 表示 bias,而非 batch size。在每一步,
\[\begin{aligned} R_t &=\underbrace{F_t+\sum_{s<t}K_{t,s}B_s}_{\text{source bias }B_t} +\underbrace{\sum_{s<t}K_{t,s}(V_s+\sigma^2)}_{\text{source variance }V_t}\\[6pt] &=\underbrace{F_t}_{\text{forcing}} +\underbrace{\sum_{s<t}K_{t,s}(B_s+V_s+\sigma^2)}_{\text{memory}}. \end{aligned}\]第一行区分误差的来源:是初始误差及其采样效应,还是 label noise 及其后续效应。第二行则将 forcing 项与累积的历史影响分开。尤其是,\(\sum_{s<t}K_{t,s}B_s\) 在第一行中属于 bias,在第二行中却属于 memory 项。使用干净标签会令 \(V_t=0\),但不会消除这部分 memory 项。这两种分解只是对同一组效应作了不同的归类;memory 项并不等同于 label-noise variance。
推导细节:从 Volterra 方程得到 bias–variance 分解
沿用正文中的 Gaussian random feature model、可实现目标和 label noise 假设,固定特征、输入分布以及预先给定的 learning-rate 和 batch-size schedule。这里的 \(K_{t,s}\) 不依赖初始误差或 label noise 方差,因此下面两个过程使用相同的 kernel。
1. 去掉 label noise,保留 minibatch 采样。保持原来的初始化,令 \(\sigma^2=0\),Volterra 方程给出 clean-label SGD 的误差:
\[B_t=F_t+\sum_{s<t}K_{t,s}B_s.\]所以 source bias 不只是 \(F_t\),还包含 clean-label 训练中的采样效应。
2. 去掉初始误差,保留 label noise。从零初始预测误差出发,forcing 项为零,因此:
\[V_t=\sum_{s<t}K_{t,s}(V_s+\sigma^2).\]这里的零初始误差,是指模型在训练开始时已经给出正确的无噪声预测,并不是将参数初始化为零。这个过程单独追踪 label noise 及其后续影响。
3. 将两个递推相加。得到
\[B_t+V_t =F_t+\sum_{s<t}K_{t,s}(B_s+V_s+\sigma^2).\]这与 \(R_t\) 满足相同的递推。又因为 \(B_0=R_0\)、\(V_0=0\),且每一步只依赖之前的时刻,逐步归纳便有 \(R_t=B_t+V_t\)。将 \(B_t\) 的表达式代回,就得到正文中的两种分组。
这些分解说明了 loss 中包含哪些效应,却还没有解释它们如何随时间衰减。要理解幂律从何而来,我们需要进一步看各个方向上的误差以多快的速度消退。
不同方向的学习速度不同
沿用前面的模型 \(f_a(x)=a^\top\phi(x)\),其中 \(\phi\) 为固定特征,\(a\) 为可训练权重。我们可以显式计算各方向上的误差消退速度,Paquette et al. (2024) 对计算最优缩放的分析就采用了这一思路。
这种速度差异可以从 loss landscape 的形状看出来:沿 Hessian 的不同特征向量方向看,loss 可以有不同的曲率。下图左侧展示了一个二次 loss 的示意:蓝色方向较陡,橙色方向较平缓。
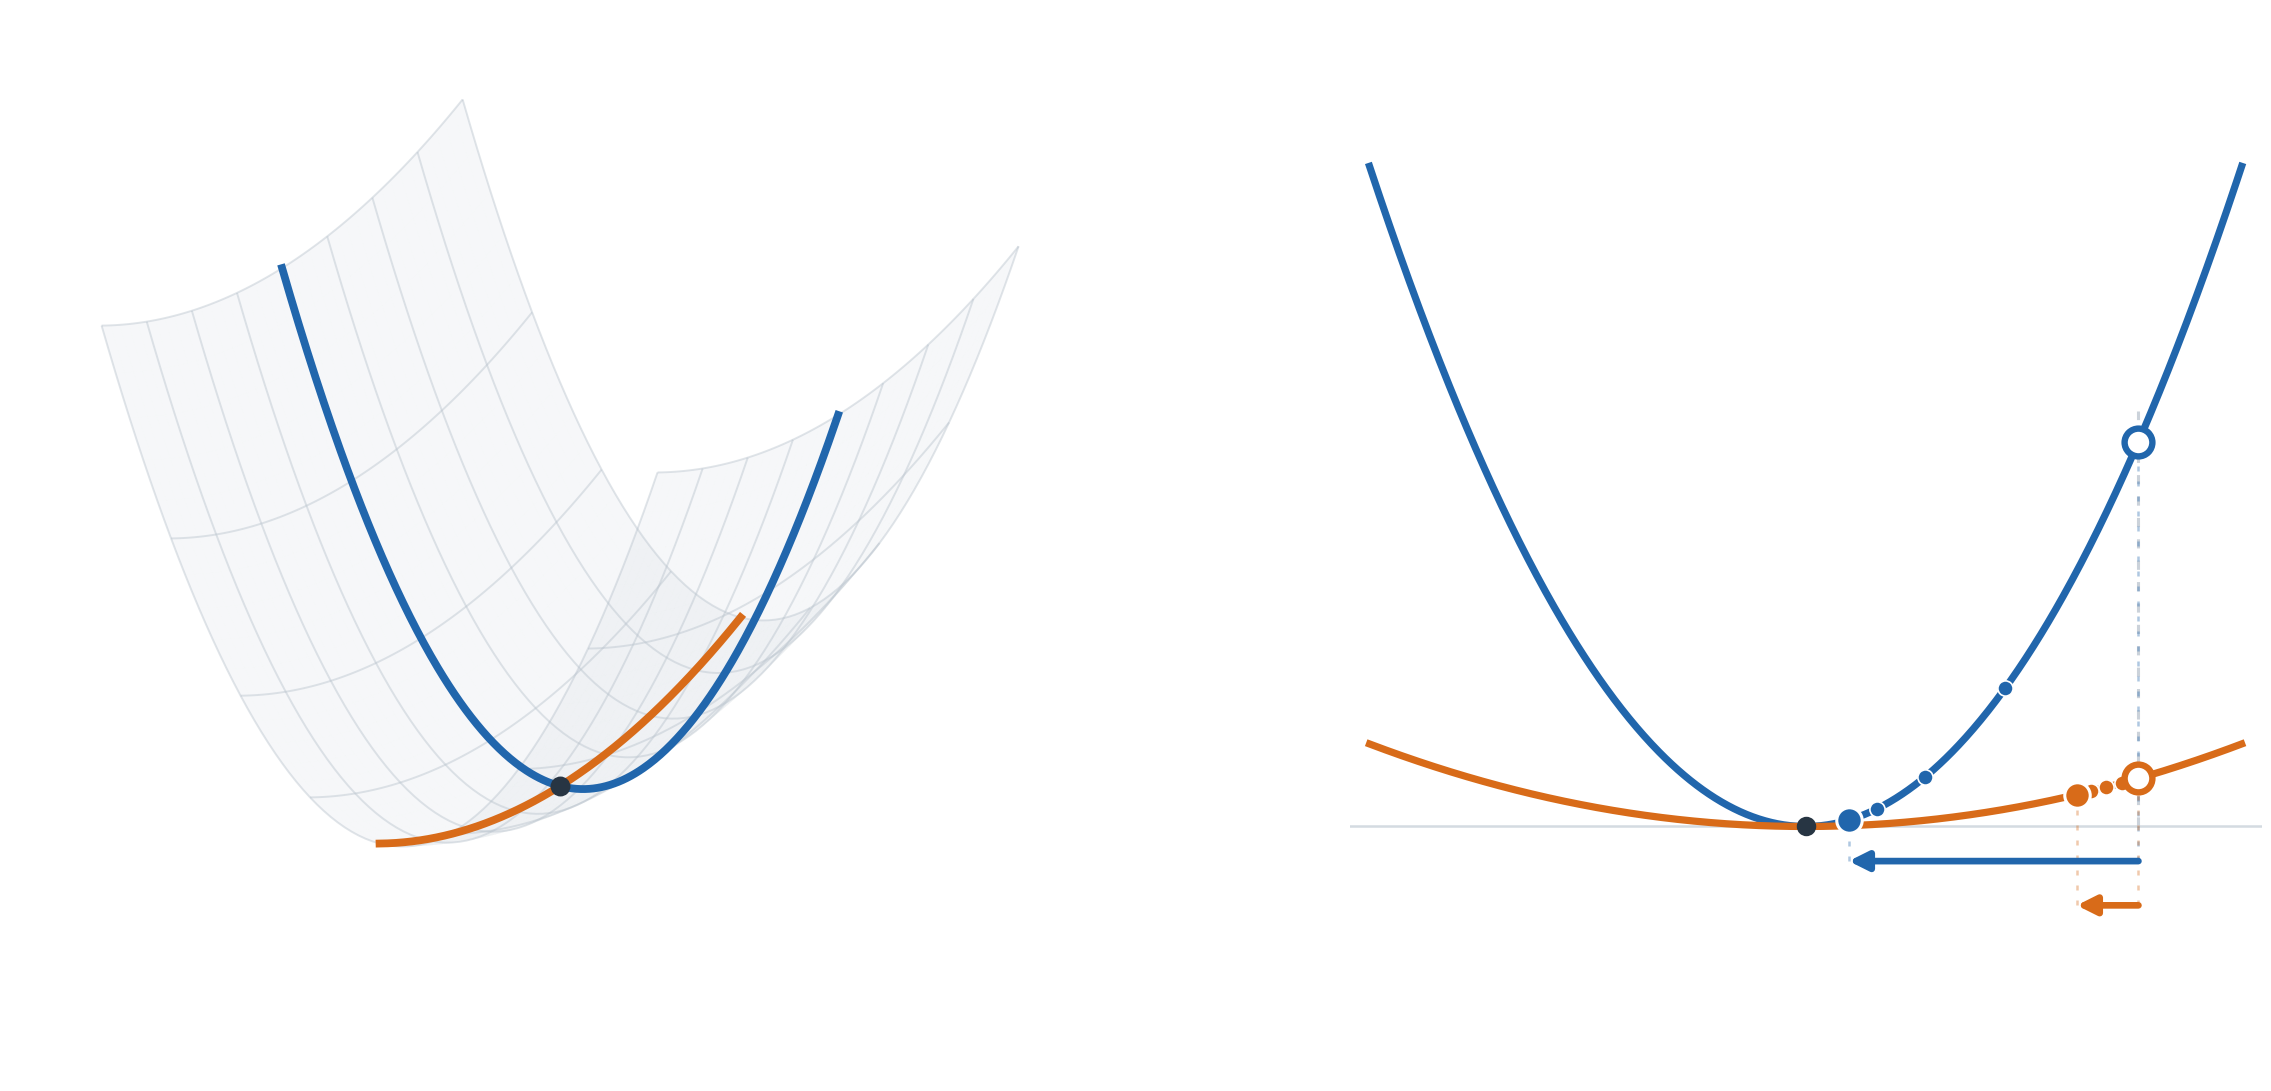
右图将这两个方向的截面放在同一坐标系中,横轴表示参数偏差,纵轴表示该方向的 loss 贡献。两个空心圆对应相同大小的初始参数偏差。使用相同的 learning rate,经过四次全梯度更新后,蓝色方向上的误差已经大幅缩小,橙色方向上的误差却只减少了一小部分。
为什么会有这样的差别?记第 \(j\) 个方向上的参数误差为 \(\rho_j\),对应的 Hessian 特征值为 \(\lambda_j\)。这一方向的 loss 贡献为 \(\frac12\lambda_j\rho_j^2\),梯度分量则为 \(\lambda_j\rho_j\)。因此,对于同样的参数偏差,正特征值越大,landscape 越陡,产生的梯度也越大。在相同且足够小的 learning rate 下,每次更新便能消除更大比例的误差。因此,我们将误差消退较快的方向简称为“快方向”,消退较慢的方向简称为“慢方向”。
用 \(\rho_{j,t}\) 表示第 \(t\) 步在这一方向上的参数误差。反复进行全梯度更新,在小步长近似下,
\[\rho_{j,t}\approx\rho_{j,0}e^{-\lambda_jT_t}, \qquad T_t=\sum_{s<t}\eta_s.\]这里的时钟 \(T_t\) 称为 intrinsic time。将某一方向的误差缩小到原来的固定比例,所需的 intrinsic time 与 \(1/\lambda_j\) 成正比。
loss 是各个方向上平方误差的加权和。如果某个方向上的初始误差几乎为零,即使这个方向学得很慢,它对 loss 的贡献也很小。学习速度和对 loss 的重要性,是两回事。
推导细节:从 squared loss 到学习时间
1. 从 squared loss 到梯度。设 \(\phi(x)\) 是输入 \(x\) 的固定特征向量,\(y\) 是其目标,\(a\) 是可训练权重。定义 population squared loss 及其 Hessian 矩阵:
\[\mathcal L(a)=\frac12\mathbb E\!\left[(a^\top\phi(x)-y)^2\right], \qquad H=\mathbb E[\phi(x)\phi(x)^\top].\]对于极小点 \(a_\star\),条件 \(\nabla\mathcal L(a_\star)=0\) 给出 \(\mathbb E[\phi(x)y]=Ha_\star\)。因此
\[\nabla\mathcal L(a) =\mathbb E\!\left[\phi(x)(a^\top\phi(x)-y)\right] =H(a-a_\star).\]梯度就是剩余参数误差经 \(H\) 变换后的结果。对于固定特征下的 squared loss,这是一个精确恒等式。
2. 从梯度到误差动力学。先考虑不含 minibatch noise 的全梯度训练。设 learning rate 为 \(\eta_t\),参数误差为 \(e_t=a_t-a_\star\),更新可以写成
\[\begin{aligned} a_{t+1}&=a_t-\eta_t\nabla\mathcal L(a_t),\\ e_{t+1}&=e_t-\eta_tHe_t=(I-\eta_tH)e_t. \end{aligned}\]设 \((\lambda_j,u_j)\) 构成对称矩阵 \(H\) 的一组标准正交特征系统,并定义 \(\rho_{j,t}=u_j^\top e_t\)。将更新投影到 \(u_j\) 上,得到
\[\begin{aligned} \rho_{j,t+1} &=u_j^\top(I-\eta_tH)e_t\\ &=(1-\eta_t\lambda_j)\rho_{j,t}, \qquad Hu_j=\lambda_j u_j. \end{aligned}\]沿 \(u_j\) 方向,梯度等于剩余误差的 \(\lambda_j\) 倍。因此,在小步长情形下,一次更新会消除该误差中 \(\eta_t\lambda_j\) 的比例。
3. 从递推关系到学习时间尺度。从初始误差 \(\rho_{j,0}\) 开始迭代,得到
\[\rho_{j,t} =\rho_{j,0}\prod_{s<t}(1-\eta_s\lambda_j).\]当 \(\eta_s\lambda_j\ll1\) 时,利用 \(\log(1-x)\approx-x\),可以得到用 intrinsic time 表示的近似:
\[\rho_{j,t}\approx\rho_{j,0}e^{-\lambda_jT_t}, \qquad T_t=\sum_{s<t}\eta_s.\]对于 \(\lambda_j>0\),用 \(T_{\mathrm{learn},j}\) 表示将误差幅度缩小固定倍数所需的 intrinsic time,用 \(t_{\mathrm{learn},j}\) 表示对应的更新次数。当 learning rate 固定为 \(\eta\) 时,
\[T_{\mathrm{learn},j}\asymp\frac1{\lambda_j}, \qquad t_{\mathrm{learn},j}\asymp\frac1{\eta\lambda_j}.\]特征值越大,学习时间越短;特征值越小,误差越持久。在时刻 \(T\),满足 \(\lambda_jT\gg1\) 的模态已经大幅衰减,而满足 \(\lambda_jT\ll1\) 的模态仍接近初始值。
4. 从各方向的误差到 loss。squared loss 对应的 excess loss 为
\[\begin{aligned} \mathcal L(a_t)-\mathcal L(a_\star) &=\frac12e_t^\top He_t =\frac12\sum_j\lambda_j\rho_{j,t}^2\\ &\approx\frac12\sum_j\lambda_j\rho_{j,0}^2e^{-2\lambda_jT_t}. \end{aligned}\]特征值决定衰减速度,各方向上的初始误差则决定其在 loss 中的权重。这就是为什么仅知道特征值还不够:我们还需要知道哪些方向对目标重要。SGD 中的 minibatch 采样会不断引入新误差;上面的全梯度计算单独刻画了已有误差如何衰减。
这些学习速度何时会产生幂律?
在恒定且稳定的 schedule 下,各方向的贡献近似按 \(e^{-2\lambda T}\) 衰减。到时刻 \(T\),大特征值方向的贡献已大幅减弱,因此剩余响应主要取决于特征值在 \(1/T\) 附近及以下的累计权重。
在我们的 random feature model 中,forcing 和单次 memory response 的累计权重可以明确写出来。固定特征为 \(\phi(x)=W^\top x\),无噪声目标为 \(x^\top\theta^\star\),输入协方差为 \(\Lambda\)。记 \(\widehat\lambda_j,\widehat u_j\) 为 \(\Lambda^{1/2}WW^\top\Lambda^{1/2}\) 的特征值及单位特征向量。从零输出权重出发,两种累计权重分别为
\[\begin{aligned} \nu_W^{\mathcal F}((0,x]) &=\sum_{0<\widehat\lambda_j\le x} \left|\left\langle\widehat u_j,\Lambda^{1/2}\theta^\star\right\rangle\right|^2,\\ \nu_W^{\mathcal K}((0,x]) &=\sum_{0<\widehat\lambda_j\le x}\widehat\lambda_j^2. \end{aligned}\]第一行累计目标在这些方向上的能量;第二行累计单次 memory response 的权重。当它们在小特征值附近呈幂律时,将对应的正指数分别记为 \(q_{\mathcal F}\) 和 \(q_{\mathcal K}\)。
我们的理论表明:在论文的大宽度、长时间极限及谱窗口条件下,forcing 和单次 memory response 呈幂律衰减,当且仅当各自的累计谱权重具有对应的幂律形式。示意地写成
\[\begin{aligned} \nu_W^{\mathcal F}((0,x])\propto x^{q_{\mathcal F}} &\quad\Longleftrightarrow\quad F_{W,>0}(T)\propto T^{-q_{\mathcal F}},\\ \nu_W^{\mathcal K}((0,x])\propto x^{q_{\mathcal K}} &\quad\Longleftrightarrow\quad \frac{B}{\eta^2}K_W(T)\propto T^{-q_{\mathcal K}}. \end{aligned}\]这里,\(F_{W,>0}\) 是 forcing 高于 loss floor 的部分,\(K_W\) 是恒定 schedule 下的单次 memory kernel;乘以 \(B/\eta^2\) 是为了除去噪声注入尺度。对单次 memory response,\(T\) 指注入后经过的 intrinsic time。
直观上,累计权重随阈值按某个幂次变化,而训练将这个阈值降到约 \(1/T\),于是同一个指数出现在时间上的衰减规律中。对有限模型,这种幂律可以出现在一个很长的中间时间区间,而不是无限持续。
下面的三联图采用谱构造
\[\lambda_j=j^{-0.8}.\]图中同时选取了快速衰减的目标系数 \(\lvert\theta_j^\star\rvert^2=e^{-j}\)。因此,特征值越小的方向,目标在其中的分量也越小。它们虽然消除误差很慢,却几乎没有初始信号需要学习;minibatch 采样仍然可能在这些方向上引入误差。
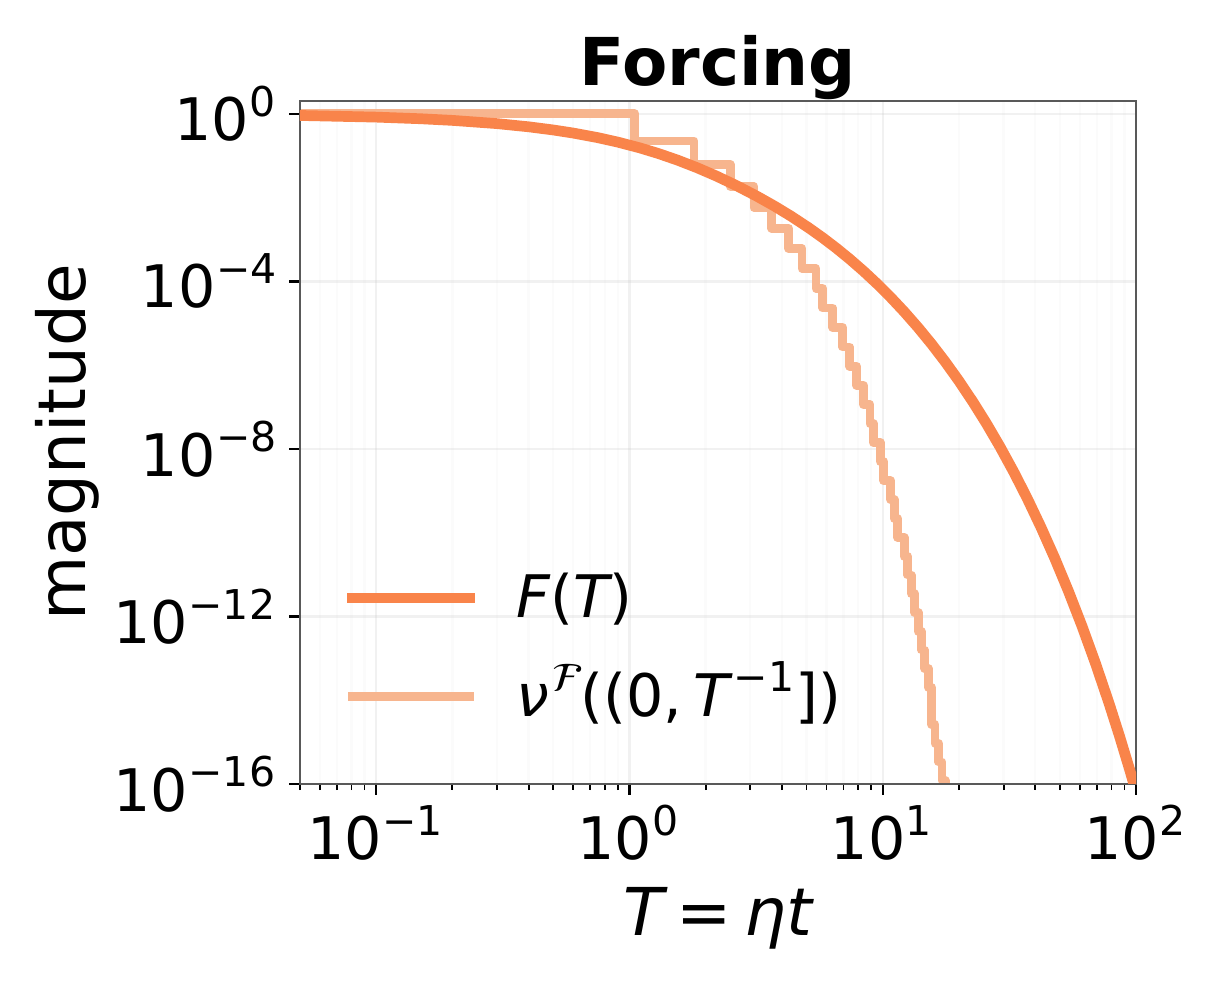
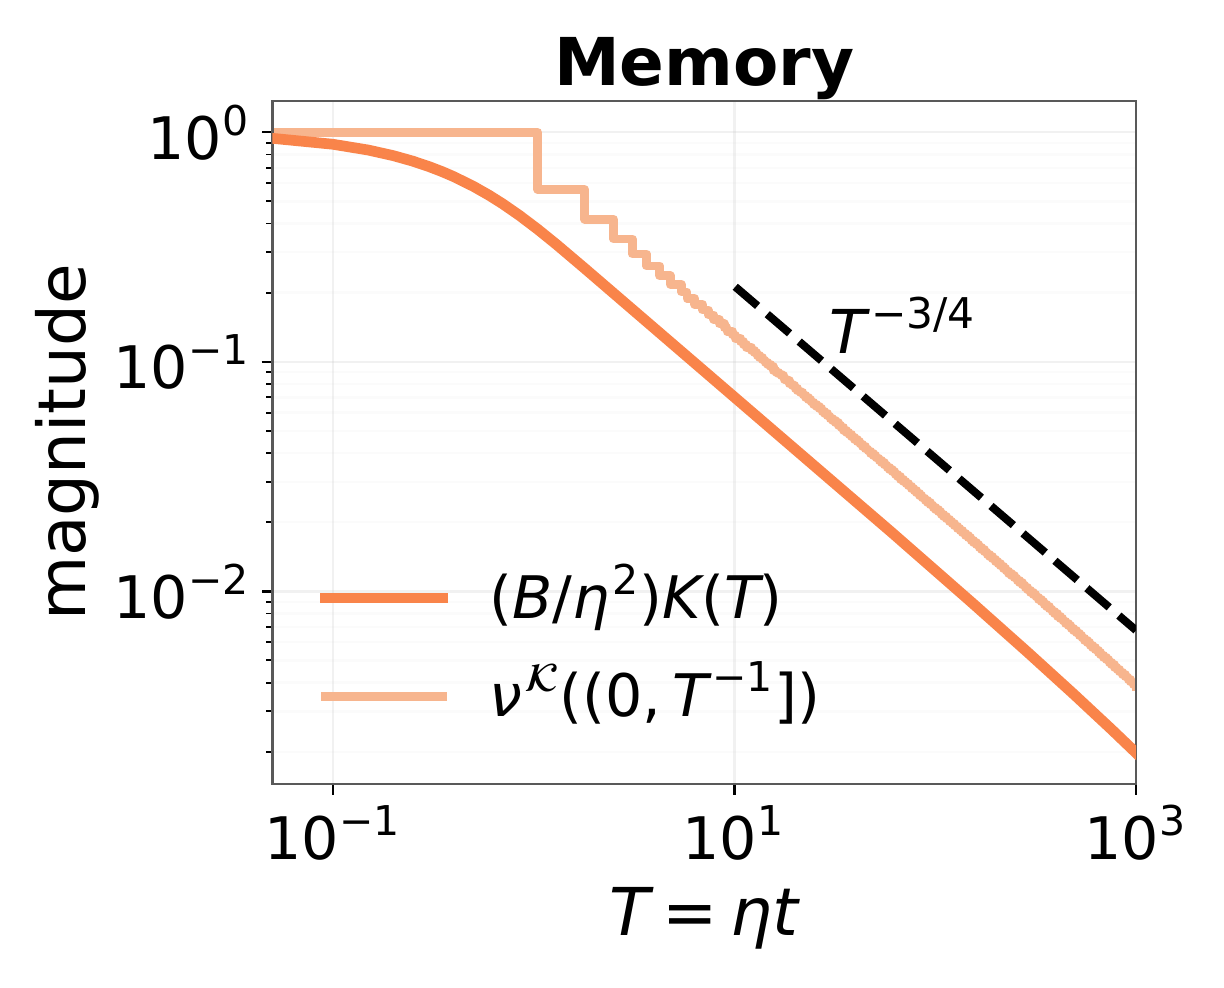
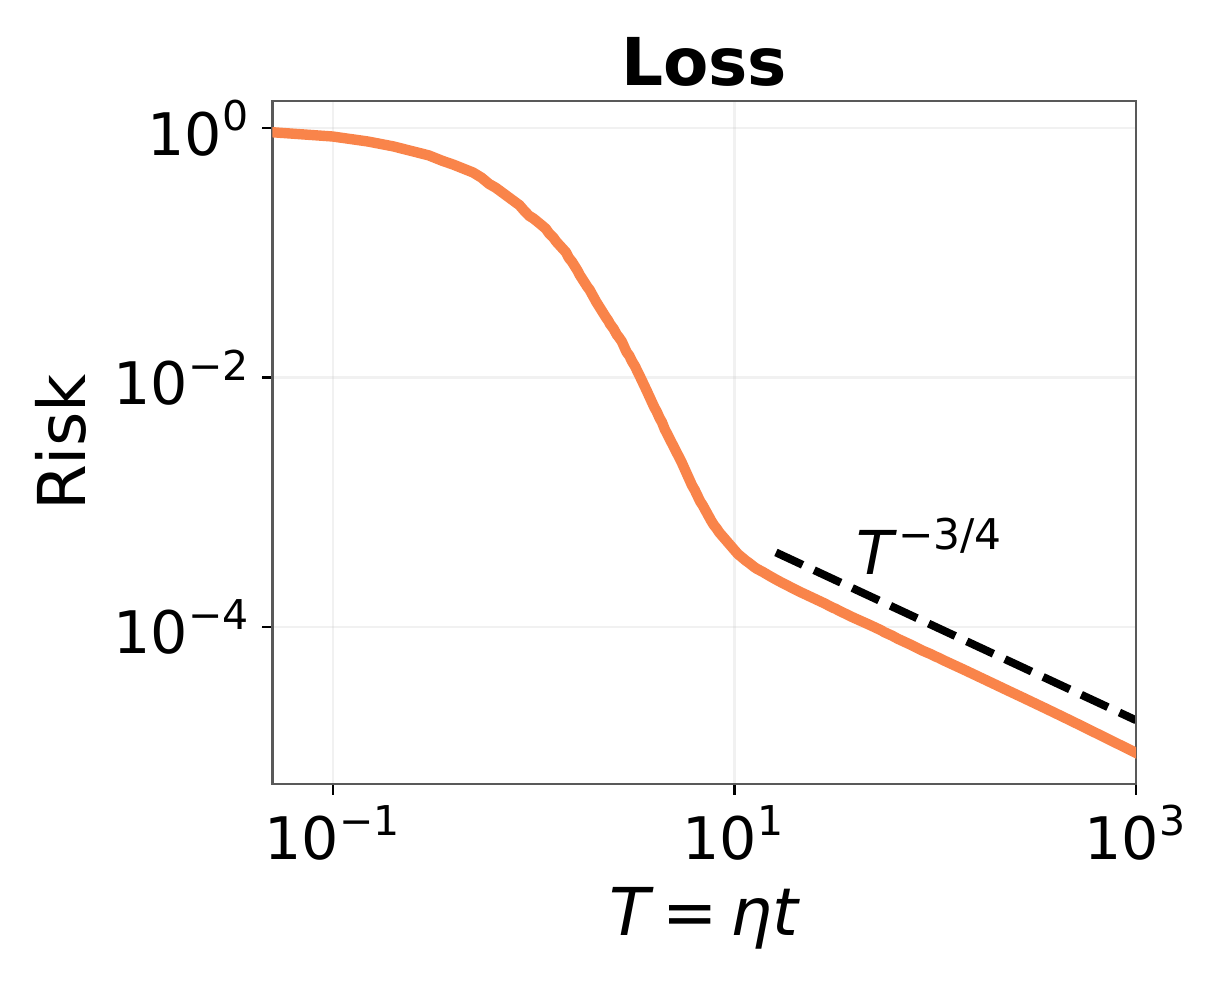
右图展示了两者如何影响实际 SGD loss:前期下降主要跟随 forcing,后期则进入由采样噪声的历史影响控制的幂律区间。同一组特征值,并不意味着 forcing 和 memory 必须具有相同的下降规律。
幂律指数告诉我们 loss 下降得多快,却不能单独说明剩余误差从哪里来。初始误差的缓慢消退和训练噪声的长期影响,都可能形成幂律尾部。解释一条学习曲线,需要区分这两部分,而不只是拟合它们相加后的指数。
上述充要关系分别适用于 forcing 和单次 memory response,并不直接给出总 loss 的指数。要得到整条 SGD loss 曲线,还需要把历次噪声注入的影响累积起来。
三类记忆
以 intrinsic time 计,用 \(k(v)\) 表示经过延迟 \(v\) 后的归一化 memory response:对于作为参照的恒定 schedule,\(k(T)=(B/\eta^2)K_W(T)\)。噪声注入强度单独给出。为了只看响应本身,先考虑每单位 intrinsic time 都注入相同强度噪声的参考情形。若 \(k(v)\asymp(1+v)^{-q_{\mathcal K}}\),到 \(T\) 时刻各次注入留下的影响相加,量级为
\[\int_0^T k(v)\,\mathrm dv \asymp \begin{cases} T^{1-q_{\mathcal K}}, & 0<q_{\mathcal K}<1 \quad(\mathrm{LM}),\\ \log T, & q_{\mathcal K}=1,\\ 1, & q_{\mathcal K}>1 \quad(\mathrm{IM}). \end{cases}\]- Long memory(LM):单次影响虽然在消退,但消退得不够快,持续注入会让累积响应继续增长。上一节的 \(q_{\mathcal K}=3/4\) 就属于这一类,等强度注入的累积响应按 \(T^{1/4}\) 增长。
- Integrable memory(IM):单次影响消退得足够快,即使持续注入,累积响应也可以趋于有限值。
在边界 \(q_{\mathcal K}=1\) 处,累积响应按对数增长。
为了比较不同数据与目标对应的响应,接下来让目标系数也按幂律衰减:
\[\lambda_j=j^{-2\alpha}, \qquad |\theta_j^\star|=j^{-\beta}.\]这里 \(\lambda_j\) 是按顺序排列的数据协方差特征值,\(\theta_j^\star\) 是对应的目标系数。\(\alpha\) 越大,谱越陡;\(\beta\) 越大,目标在慢方向上的权重越小。
在目标能量有限的 LM/IM 区域内,利用上一节的累计谱权重判据,目标相关的 forcing 项与单次 memory response 对应的指数为
\[q_{\mathcal F}=\frac{2\alpha+2\beta-1}{2\alpha}, \qquad q_{\mathcal K}=2-\frac{1}{2\alpha}.\]当谱衰减得更慢,即 \(0<\alpha<1/4\) 时,单次 memory response 的权重 \(\lambda_j^2\) 在大量小特征值方向上累加后,仍然会随模型宽度增长。此时,宽度不只是决定幂律在什么时候结束,还直接影响 memory response 本身。这就是 finite bulk(FB):它不能只用一个与宽度无关的正衰减指数来概括。
下面两张相图分别使用响应指数和谱、目标参数来表示这些区域。
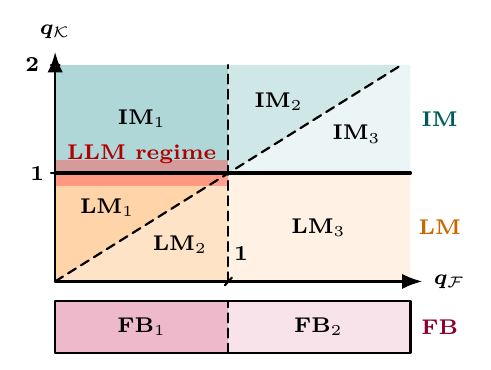
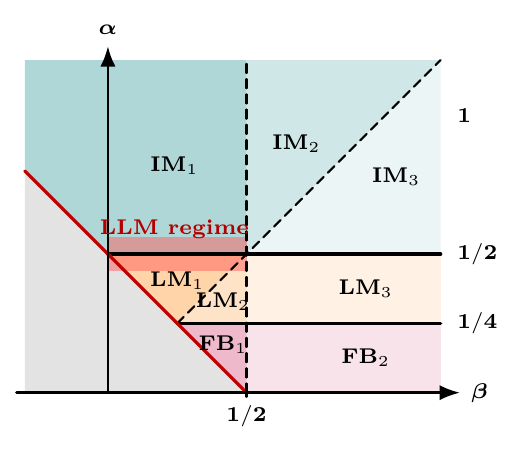
先看左图的水平实线:它在 \(q_{\mathcal K}=1\) 处把 LM 与 IM 分开,对应上面积分的两种行为。右图把这一分界对应到谱的衰减速度 \(\alpha=1/2\);FB 则单独占据 \(\alpha<1/4\) 的区域。
更细的区域比较目标相关的 forcing 衰减项与 memory 的衰减速度,以及前者的时间积分是否有限。左图中的斜虚线对应 \(q_{\mathcal F}=q_{\mathcal K}\),竖虚线对应 \(q_{\mathcal F}=1\)。
到这里,我们区分了噪声影响如何消退和累积。实际训练还会改变每次注入的强度,而这正是 learning rate 和 batch size schedule 可以控制的部分。
训练 schedule 如何改变响应
改变噪声注入的强度,可以直接改变 loss 曲线的形状。一个熟悉的例子是 learning-rate decay:learning rate 开始下降后,loss 反而可能下降得更快。在 warmup–stable–decay(WSD)训练(Hu et al. (2024))中,learning rate 在 warmup 后保持不变,直到最后的衰减阶段。观察下面 MiniCPM 实验中的灰绿色曲线:衰减一开始,原先平缓的下降就变成了陡降。同样的现象出现在多个不同的训练阶段。
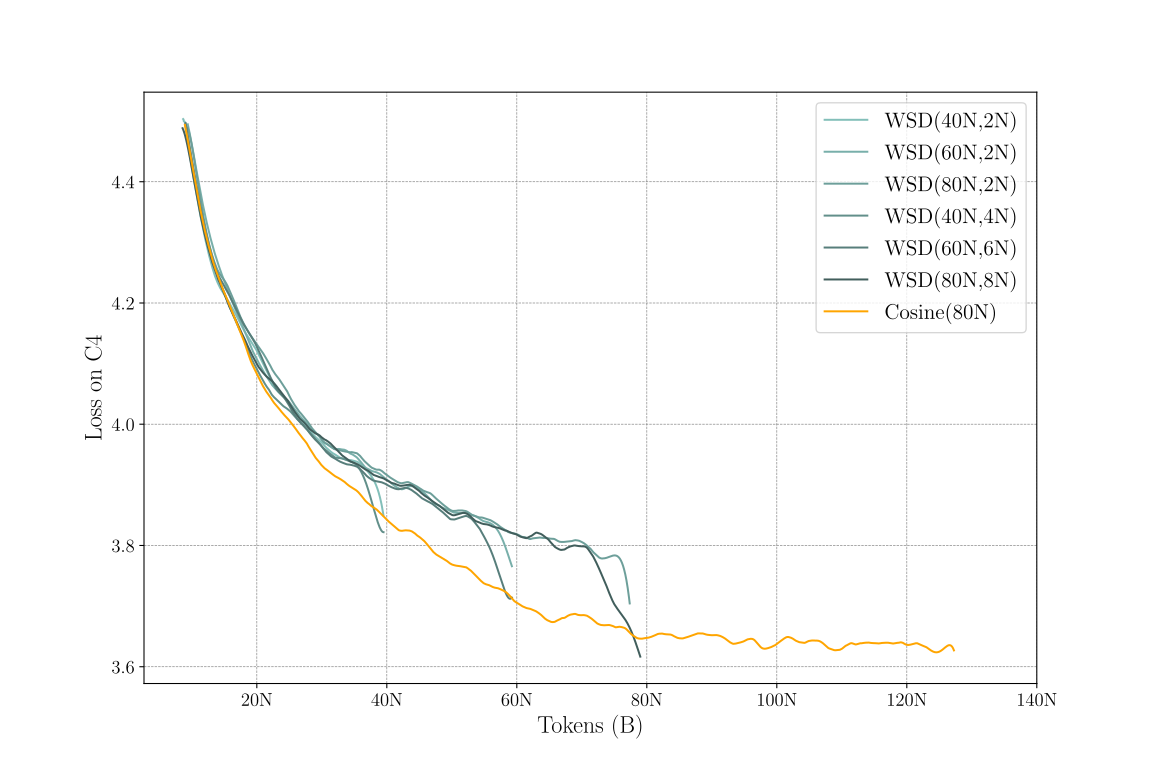
为什么减小更新步长,loss 反而下降得更快?这些向下的拐点看起来像是模型学得更快了,但减少随机更新造成的误差同样会降低 loss。如果退火确实有帮助,为什么不能用更激进的 schedule 让 loss 不断加速下降?
要区分这两种效应,我们从普通 SGD 出发,回到 intrinsic time。降低 learning rate 既会缩短全梯度更新的步长,也会减小更新噪声;增大 batch size 则能在不缩短这一步长的情况下减小噪声。对应的时钟以及 batch size 与 learning rate 的比值为
\[T_t=\sum_{s<t}\eta_s, \qquad r_t=\frac{B_t}{\eta_t}.\]一次更新让时钟前进 \(\eta_t\),并注入尺度为 \(\eta_t^2/B_t\) 的方差。除以这次推进的时间,就得到每单位 intrinsic time 的噪声尺度:
\[\frac{\eta_t^2/B_t}{\eta_t} =\frac{\eta_t}{B_t} =\frac{1}{r_t}.\]\(T_t\) 记录前文的确定性学习过程推进了多少,\(1/r_t\) 则描述每单位推进伴随的噪声尺度。用 \(r(T)\) 表示沿这一时钟变化的比值,就能把这两种效应分开。
步长变小后,loss 仍可能暂时下降得更快,因为旧误差在消退的同时,新噪声也在不断产生误差。固定 batch size 时,降低 learning rate 既减少每一步推进的 intrinsic time,也减少新噪声对 loss 下降的抵消。如果降噪的收益超过推进变慢的代价,就可能出现前面 WSD 图中的陡降;这并不说明模型学习信号的速度加快了。
这种区分也出现在 Li et al. (2025) 的 functional scaling law(FSL) 中:他们在 kernel regression 中用 intrinsic time 描述训练进程,用 learning rate 与 batch size 的比值控制噪声注入,再通过 forgetting kernel 追踪噪声对后续 loss 的影响。
这将增大 batch size 与衰减 learning rate 联系了起来(Smith et al. (2018)):两者都会降低每单位 intrinsic time 的噪声。由于先前的噪声仍可能影响 loss,我们必须匹配整个比值路径,而不仅是它的终值。
上一节将单次响应累加起来。现在,各个时刻产生的噪声不再具有相同强度:我们仍然累加它们留到终点的影响,只是每次注入都要乘上当时的强度。回到幂律 random feature model,在 LM/IM 的稳定 schedule 下,计入噪声反馈后,可用下面的量级关系描述预测风险:
\[R(T)\asymp F(T)+ \int_0^T \frac{F(u)+\sigma^2}{r(u)} \,k(T-u)\,\mathrm du.\]这里,\(R\) 是预测风险,\(F\) 是 random feature model 的 forcing 项,其中包含有限宽度带来的 loss floor;\(\asymp\) 允许相差乘法常数。
对于过去的某个时刻 \(u\),\(F(u)+\sigma^2\) 在这一量级关系中表示剩余预测误差和 label noise 提供的噪声来源。除以 \(r(u)\),是让 schedule 调整当时每单位 intrinsic time 的注入强度;再乘以 \(k(T-u)\),就得到它对终点 \(T\) 的贡献。即使没有 label noise,剩余预测误差仍会产生 minibatch noise,因此积分项不会随 \(\sigma^2=0\) 一起消失。
相对同一 schedule 下的 clean-label SGD,label noise 会带来额外 loss。在上述幂律区间内,即使后续注入被压得很小,早期噪声仍会留下按 \(k(T)\sim T^{-q_{\mathcal K}}\) 衰减的尾部。因此,额外 loss 的下降指数不会超过 \(q_{\mathcal K}\),这就是 memory ceiling。
更激进的退火不能保证 loss 持续加速下降,因为它受到两种限制。首先,减少新噪声不会立即清除早期噪声:上面的 memory ceiling 限制了这部分额外 loss 在 intrinsic time 下的幂律指数,而不是图中按 token 计的短期下降速度。其次,更快地降低 learning rate 也会减慢时钟:固定 batch size 和 token 预算时,积累的 intrinsic time 更少,信号学习和旧误差消退的进展也更少。因此,退火能够减少新误差,却不能跳过旧误差的消退过程;过强的退火还会拖慢这一过程。
当单次 memory response 和比值增长都服从幂律时,将额外 loss 与 clean-label SGD 的 excess loss 比较,会得到三种结果:
- 破坏:额外 loss 不以正幂次衰减。
- 改变:额外 loss 比 clean-label SGD 的 excess loss 衰减得更慢,从而决定一个新的指数。
- 保持:额外 loss 的衰减至少同样快,因此 clean-label SGD 的指数保持不变。
下图比较了 clean-label SGD 的 excess-loss 指数 \(q_0\)(描述 loss 高于其 floor 的部分按 \(T^{-q_0}\) 衰减)与比值增长指数 \(\vartheta\)(由 \(r(T)\sim T^\vartheta\) 定义)。clean-label SGD 仍包含 minibatch noise,因此 \(q_0\) 一般不等于 forcing 指数 \(q_{\mathcal F}\)。
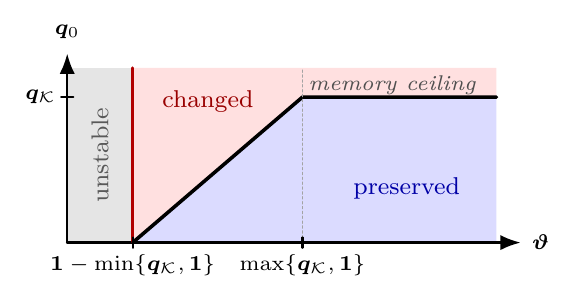
固定 \(q_0\),沿水平方向向右移动,也就是增大 \(\vartheta\)。如果 \(q_0<q_{\mathcal K}\),我们最终会从改变区域进入保持区域:此时额外 loss 的衰减速度至少与 clean-label SGD 的 excess loss 一样快。如果 \(q_0>q_{\mathcal K}\),无论向右移动多远,这条水平线始终在 memory ceiling 之上。额外 loss 的衰减指数以 \(q_{\mathcal K}\) 为上限,因此更激进地抑制噪声,也无法恢复 clean-label SGD 的指数。
从理论走向 LLM 预训练
前面的分析将 schedule 的作用分成了两部分:intrinsic time 记录学习过程推进了多少,\(r(T)\) 控制沿途的噪声注入。对于表示不断变化的 LLM,这两个量是否仍然有用?我们先比较同一条比值路径的不同实现,再检验改变这条路径后,能否预测新的 loss 曲线。
同一条比值路径的两种实现
先保持比值路径相同,但用不同方式实现它:一次运行固定 batch size、降低 learning rate,另一次运行固定 learning rate、增大 batch size。将两者的时钟和比值路径匹配起来。
我们用普通 SGD,在 6.5B 个 OpenWebText token 上训练了一个 300M 的 LLM,进行了这一比较。所有运行共享前 80% 的 token 预算,然后从同一个 checkpoint 分支,使用剩下的 20%。在固定 batch size 的运行中,WSD 在最后这段训练中逐渐降低 learning rate,而 8-1-1 则分为两个 learning rate 更低的阶段,每个阶段占 10%。如果 intrinsic time 和比值路径捕捉到了 schedule 的主要影响,那么每组 learning rate/batch size 配对的运行都应沿着近乎相同的 loss 曲线前进。

先看蓝色的两条 WSD 曲线:以 optimizer step 为横轴时,它们相互分离;换成 intrinsic time 后,它们便近乎重合。橙色的两条 8-1-1 曲线也出现了同样的变化。两种实现处理相同数据所需的更新次数不同,因此直接比较 step 会错开它们的训练进程。
蓝色与橙色并没有合成同一条曲线,因为 WSD 与 8-1-1 采用了不同的 \(r(T)\) 路径。这个比较说明,在这些运行中,同一条路径可以通过改变 learning rate 或 batch size 来实现,并产生非常相近的 loss 响应。
拟合一种 schedule,预测另一种
相同路径的不同实现可以对齐,接下来要解释的是不同路径之间的差异:从 8-1-1 的两次 learning-rate 降档中拟合出的响应,能否预测 WSD 逐渐衰减 learning rate 时的 loss?
对于 LLM 的 validation loss,我们通过拟合确定各分量函数,而不直接使用 random feature model 中的精确量。我们的起点是 Li et al. (2025) 的七参数实用 FSL:他们已在 8-1-1 上拟合,并用拟合结果预测未参与拟合的 WSD 和 cosine 曲线。我们沿用这一先拟合、再跨 schedule 预测的流程,并改编其参数化方式:他们的固定 batch size surrogate 描述 learning rate 降档带来的响应,而我们直接用 batch size 与 learning rate 比值的倒数为噪声注入加权。这样得到的 forcing–memory surrogate 也能用于固定 learning rate、改变 batch size 的情形:
\[\widehat L(T) =L_\infty+A_{\mathcal F}(1+T)^{-q_{\mathcal F}} +\int_0^T \frac{A_0+A_1(1+u)^{-q_{\mathcal F}}}{r(u)} \bigl(1+c_{\mathcal K}(T-u)\bigr)^{-q_{\mathcal K}} \,\mathrm du.\]这个公式沿用前文的结构,将 baseline 与历次噪声注入留下的影响相加:
- \(L_\infty+A_{\mathcal F}(1+T)^{-q_{\mathcal F}}\) 描述 baseline 如何下降并接近 floor。
- \(A_0+A_1(1+u)^{-q_{\mathcal F}}\) 将噪声源分成不随时间下降的一部分,以及随训练逐渐减弱的一部分。除以 \(r(u)\),就得到 schedule 调节后的注入强度。
- \(\bigl(1+c_{\mathcal K}(T-u)\bigr)^{-q_{\mathcal K}}\) 描述时刻 \(u\) 的注入到 \(T\) 时还留下多少影响。其中 \(c_{\mathcal K}\) 设置消退的时间尺度,\(q_{\mathcal K}\) 控制长时间后的衰减速度。
这些分量由 loss 曲线拟合得到;baseline 并不是单独测出的无噪声轨迹,噪声源幅度 \(A_0,A_1\) 也不由 \(L_\infty,A_{\mathcal F}\) 固定。
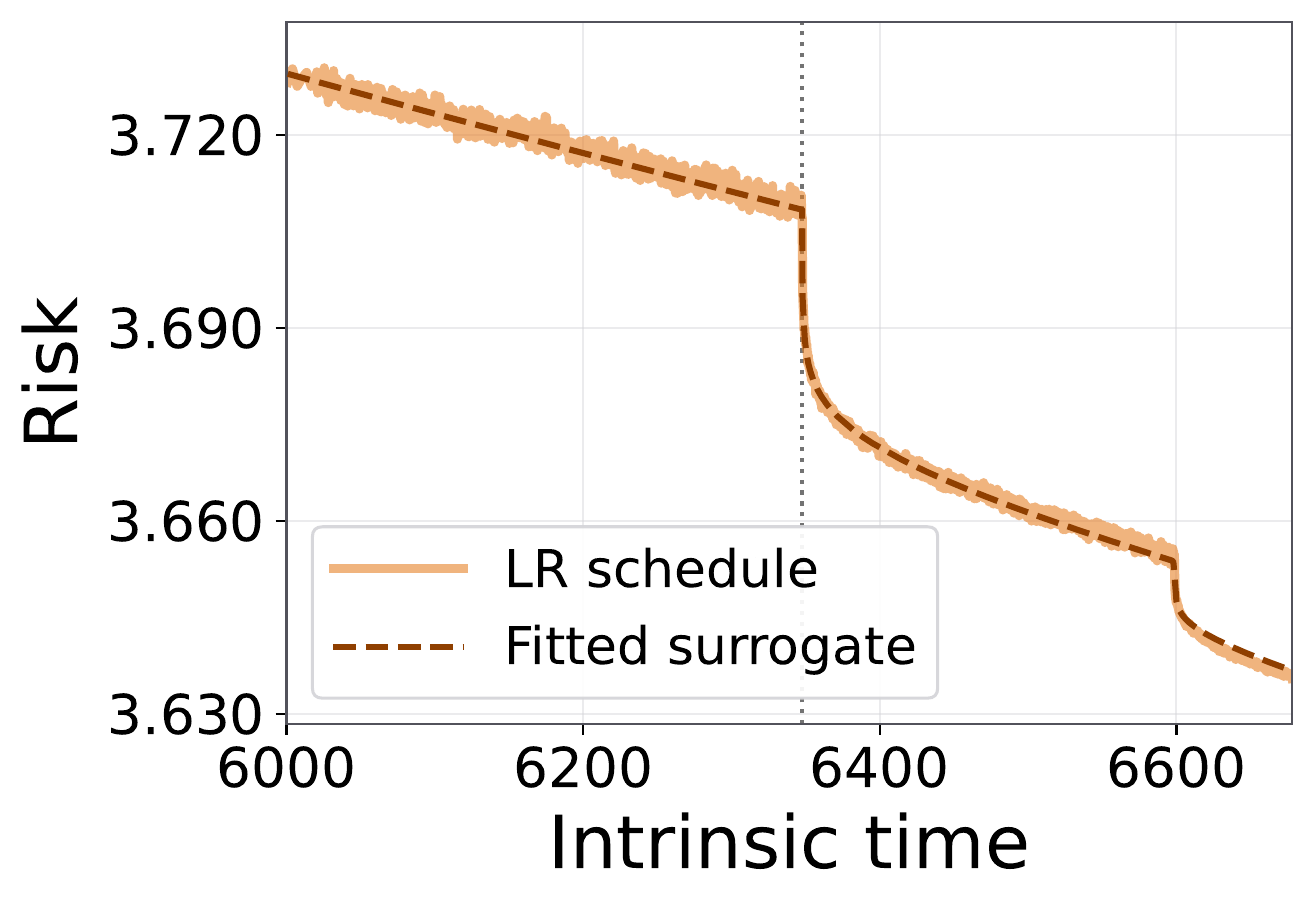
这里取 \(q_{\mathcal K}=1\) 作为简化,因为后文展示的自由拟合在不同数据集和模型大小下,都给出了接近 1 的 memory exponent。我们用固定 batch size 的 8-1-1 运行所测得的 validation loss 拟合其余六个参数,随后固定所有参数,仅将比值路径替换为 WSD 的路径。拟合过程中没有使用 WSD 分叉后的 loss。
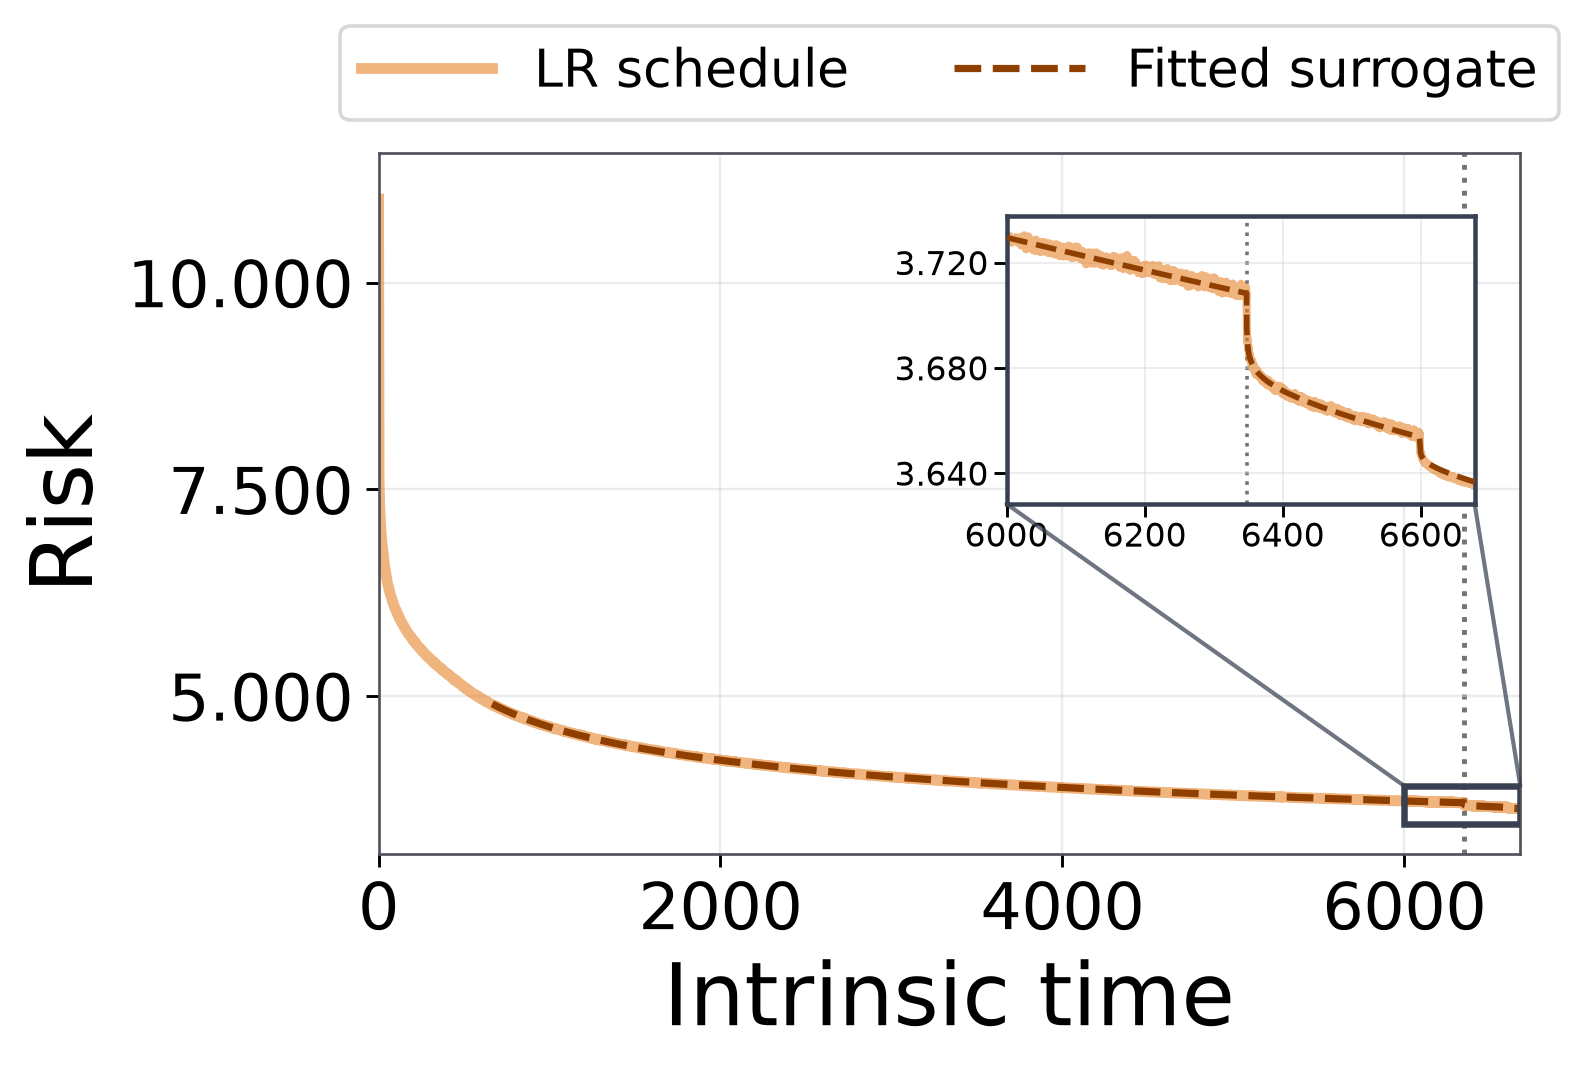
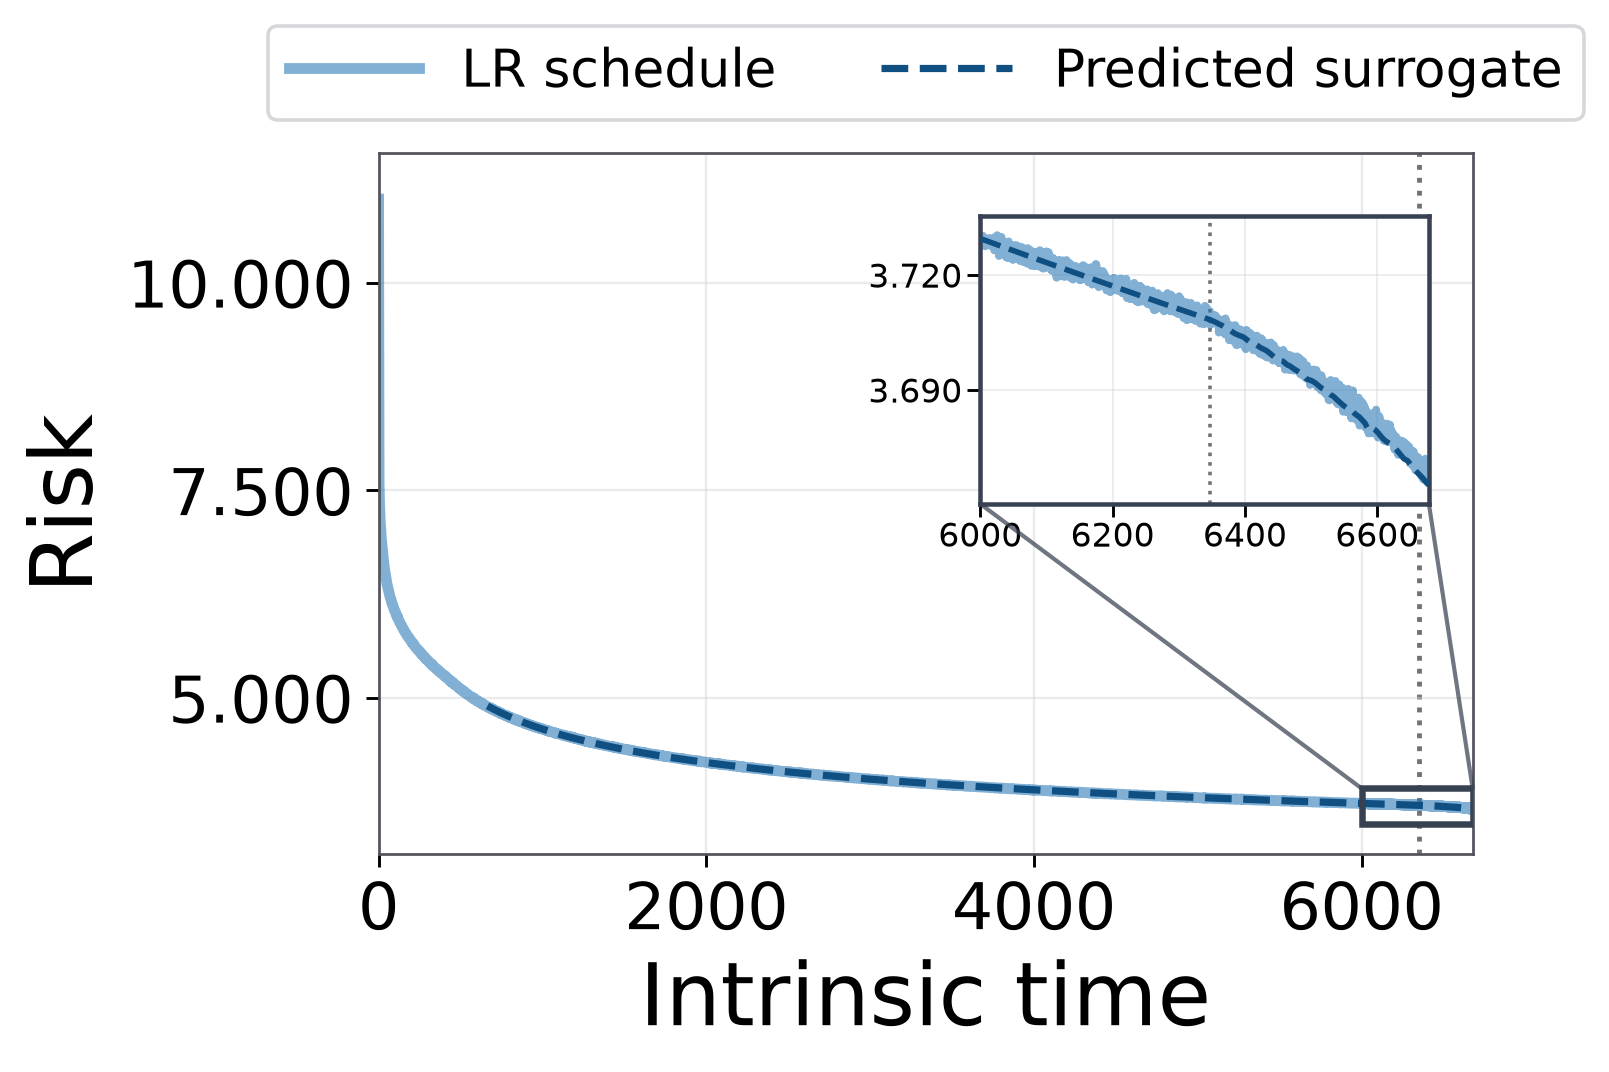
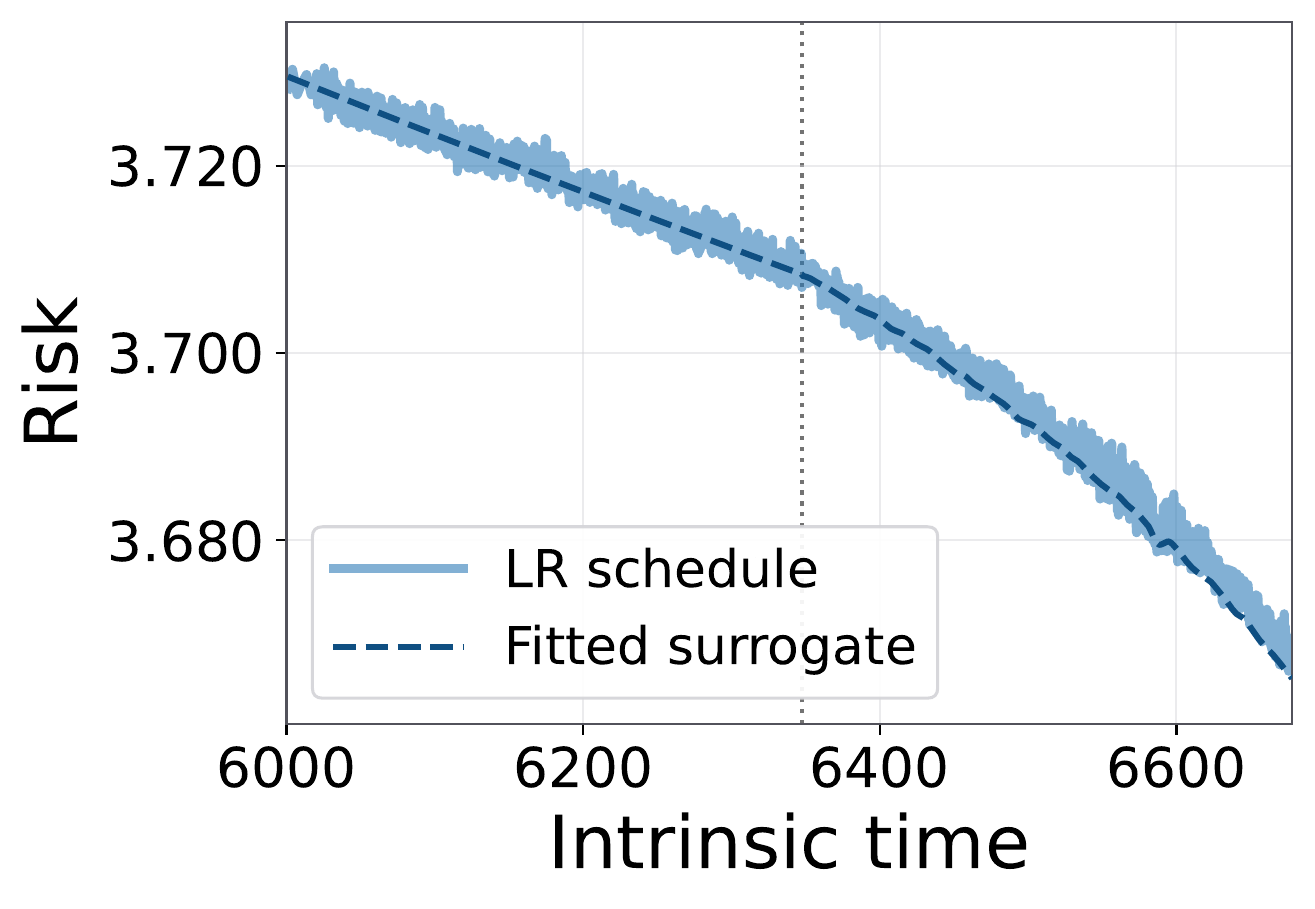
下面左图中,surrogate 拟合了 8-1-1 的两次阶梯式下降。换入 WSD 的比值路径后,中图的预测就变成了逐渐加快下降的曲线,并跟随了实测 loss。点线之前,两次运行共享同一段训练历史;真正检验跨 schedule 预测的是点线之后的 WSD 尾段。
8-1-1 拟合的 RMSE 为 \(1.31\times10^{-3}\) nats/token。固定所有参数后,对 WSD 分叉后尾段的预测 RMSE 为 \(1.58\times10^{-3}\)。
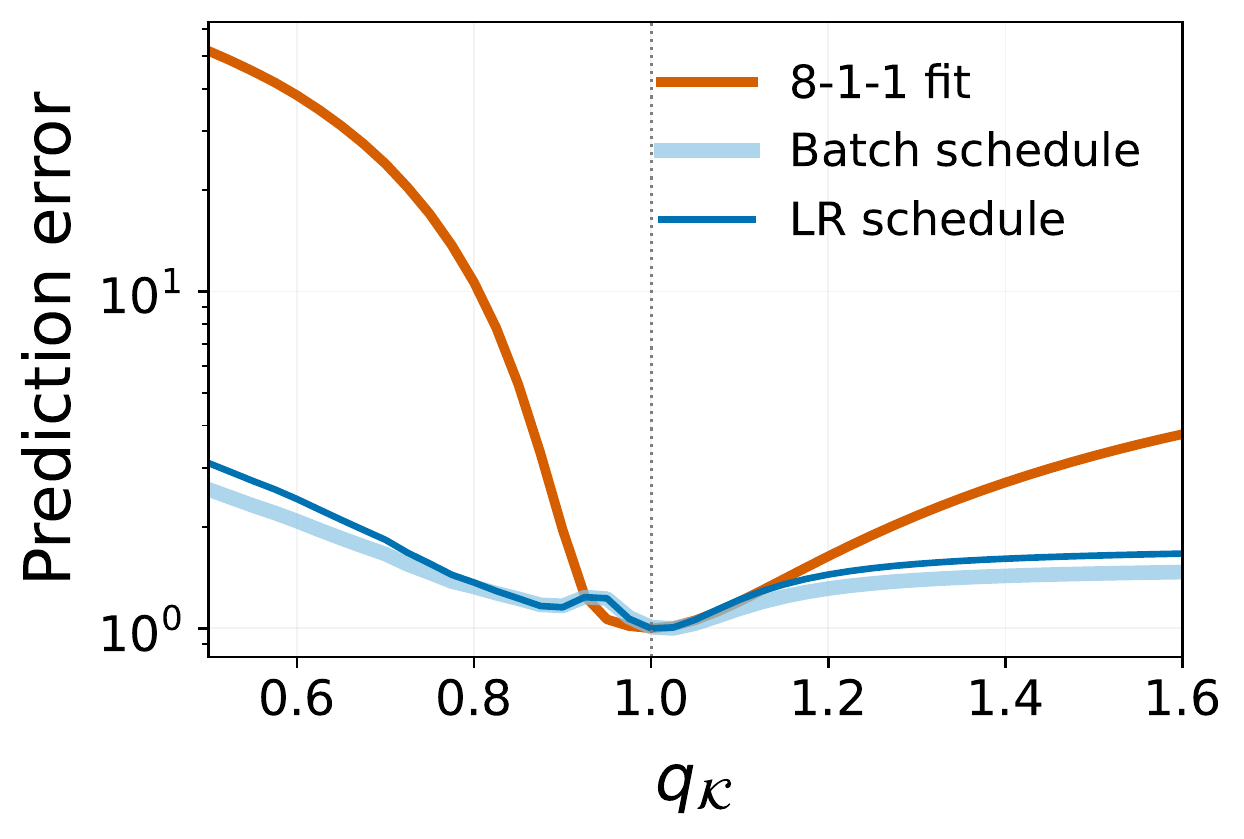
右图进一步检查这一预测对 memory exponent 的选择有多敏感。归一化预测误差在 \(q_{\mathcal K}\) 接近 1 时最小。这里比较的是不同 exponent 的预测表现,并不是独立测出了真实的 memory exponent。
一个学习曲线模型,应当通过预测训练发生变化后的结果来赢得我们的信任。
实验与 surrogate 细节
训练与匹配。初步的 30M 实验从一个已充分训练的普通 SGD checkpoint 出发,沿十一条比值路径继续训练,全部在相同的 intrinsic time 结束。在 300M 比较中,每组 learning rate/batch size 配对的运行都以若干次更新为一组,匹配数据量、intrinsic time 增量和 \(B/\eta\)。
Surrogate 参数。七个参数分别是 loss floor \(L_\infty\)、forcing 项幅度 \(A_{\mathcal F}\)、噪声源幅度 \(A_0,A_1\)、memory 项的时间尺度参数 \(c_{\mathcal K}\),以及指数 \(q_{\mathcal F},q_{\mathcal K}\)。这一近似将有效响应分离为 \(K(n,s)\approx J(T_s)k(T_n-T_s)\),其中 \(J\) 是噪声源幅度,\(k\) 是传播 kernel。
当 \(q_{\mathcal K}=1\) 时,其余六个参数只用原始、未平滑的 8-1-1 测量值拟合;拟合中没有使用 WSD 分叉后的 loss。指数扫描图对每个固定指数重复这一过程,并评估由此得到的 WSD 预测误差。
Hybrid Muon。一次简短的校准为这些运行选出了不同的时钟和比值:\(\widetilde T=\sum_t\eta_t^2\) 和 \(\widetilde r=B/\eta^2\)。这些经校准的量同样使其配对曲线靠拢。
为什么拟合出的 memory exponent 接近 1?
上一节比较了不同 memory exponent 下的 WSD 预测表现。这里换一种检查方式:只使用 8-1-1 曲线,让全部七个参数自由参与拟合,不预先指定 \(q_{\mathcal K}\)。在不同数据集和模型大小下,拟合得到的值仍然接近 1:
| 数据集与设置 | \(q_{\mathcal K}\) | \(q_{\mathcal F}\) |
|---|---|---|
| OpenWebText, 124M, 2.5B tokens | 1.017 | 0.374 |
| FineWeb sample-10BT subset, 124M, 2.5B tokens | 0.952 | 0.405 |
| peS2o V2 s2orc full text, 124M, 2.5B tokens | 0.995 | 0.365 |
| OpenWebText, 300M, 6.5B tokens | 0.989 | 0.291 |
当 \(q_{\mathcal K}=1\) 时,surrogate 中的 kernel 在足够长的时间间隔下按 \(1/(T-u)\) 消退。这正好对应前文累积响应从有限值转向持续增长的边界;在边界上,等强度注入的累积响应按对数增长。因此,这些拟合得到的响应指数都接近理论中的 LM/IM 边界。
一个可能的解释是,不同文本语料共享某些统计结构,使模型中的噪声响应具有相近的衰减规律。另一种可能是,表示学习与优化过程会逐渐塑造相似的有效谱结构,使 memory exponent 靠近 1。我们将在未来的工作中检验这些猜测,研究数据与训练动力学如何共同影响 LLM 中的 \(q_{\mathcal K}\),以及为什么它在这些实验中接近 1。
延伸阅读
- 经验 scaling law:Kaplan et al. (2020), Scaling Laws for Neural Language Models。语言模型 loss 如何依赖模型大小、数据量和计算量。
- 谱模型:Paquette et al. (2024), 4+3 Phases of Compute-Optimal Neural Scaling Laws。一个可求解模型,将数据与目标的结构联系到计算最优的不同区域。
- Learning rate 与 batch size:Smith et al. (2018), Don’t Decay the Learning Rate, Increase the Batch Size。用增大 batch size 替代 learning rate 衰减的实验。
- 预测完整轨迹:Li et al. (2025), Functional Scaling Laws in Kernel Regression: Loss Dynamics and Learning Rate Schedules。Intrinsic time 理论,以及对 LLM 学习曲线的 surrogate 预测。
- 最优 schedule:Bordelon and Mori (2026), Theory of Optimal Learning Rate Schedules and Scaling Laws for a Random Feature Model。最优退火如何依赖谱与任务。
本文基于 From Spectra to Joint Schedules in LLM Pre-training: 3+3(+2) Scaling-Law Regimes(Wang et al. (2026)),由 Yichen Wang、Fanghui Liu 和 Yudong Chen 合作完成。