学习曲线何时遵循幂律?
发布时间:
论文(arXiv) · 代码(GitHub) · English
我们在部分情形下给出了幂律 scaling law 成立的充要条件,指出 intrinsic time 以及 batch size 与 learning rate 的比值可以调控这些规律,并在 300M nano-GPT 的训练中成功预测了 loss 曲线。这也展示了一个简单模型如何为 LLM 预训练提供思路。
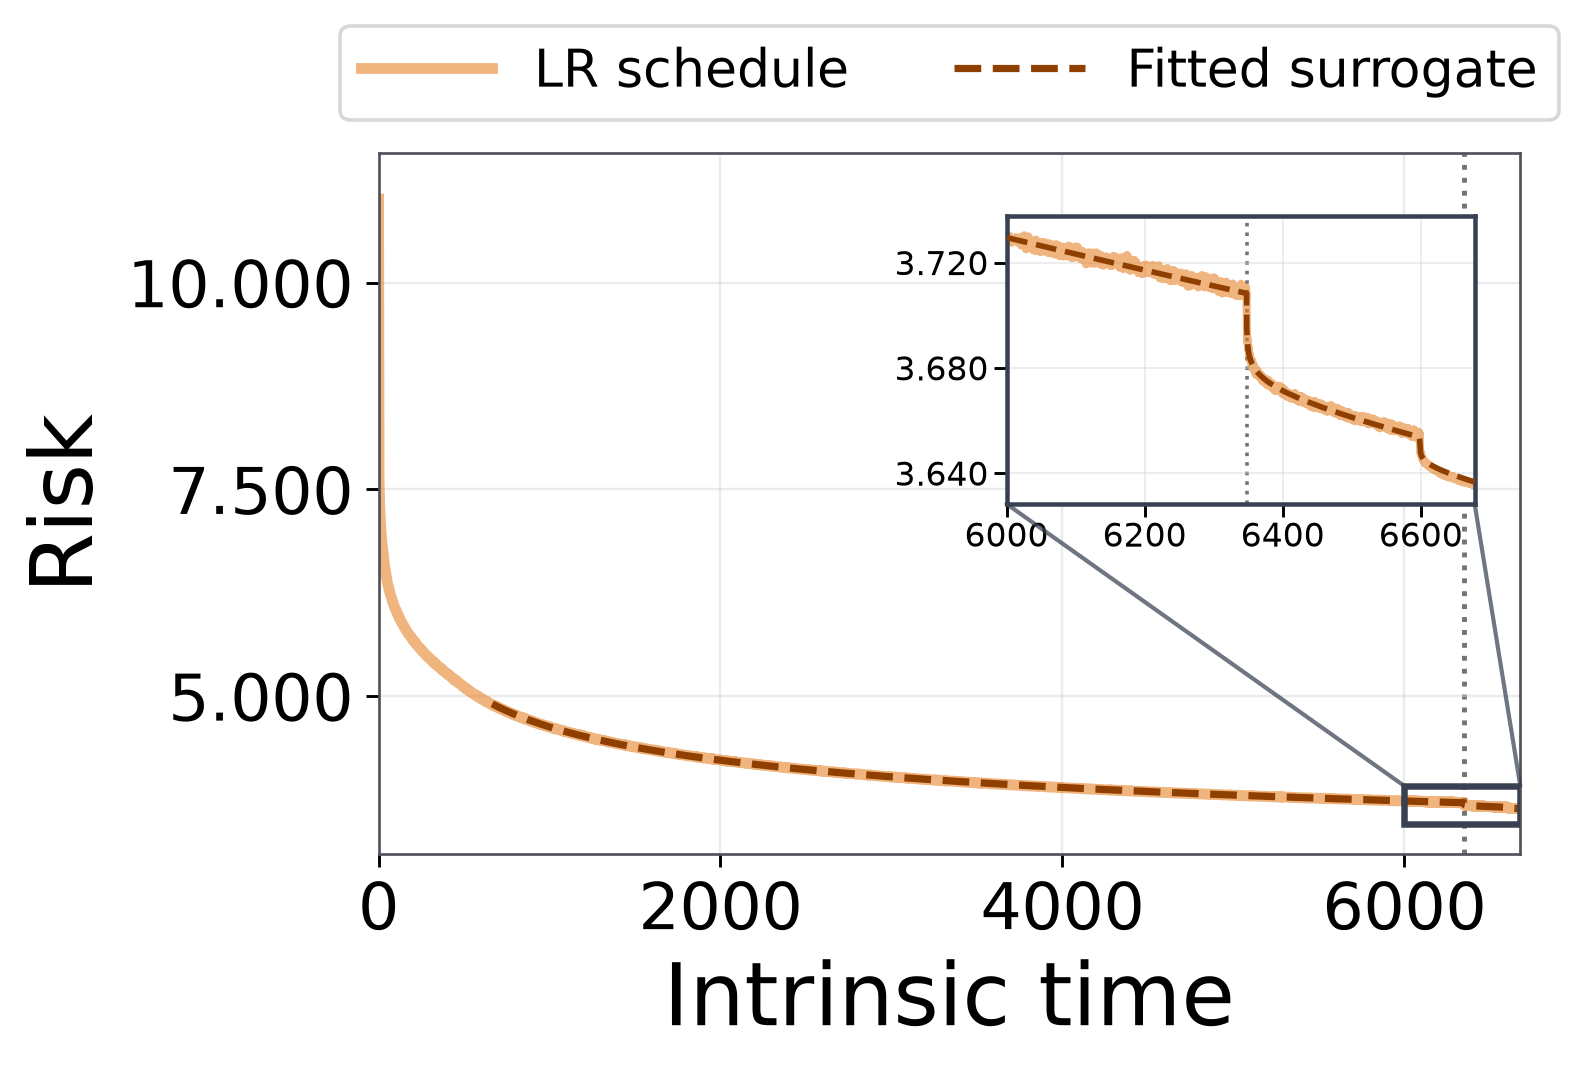
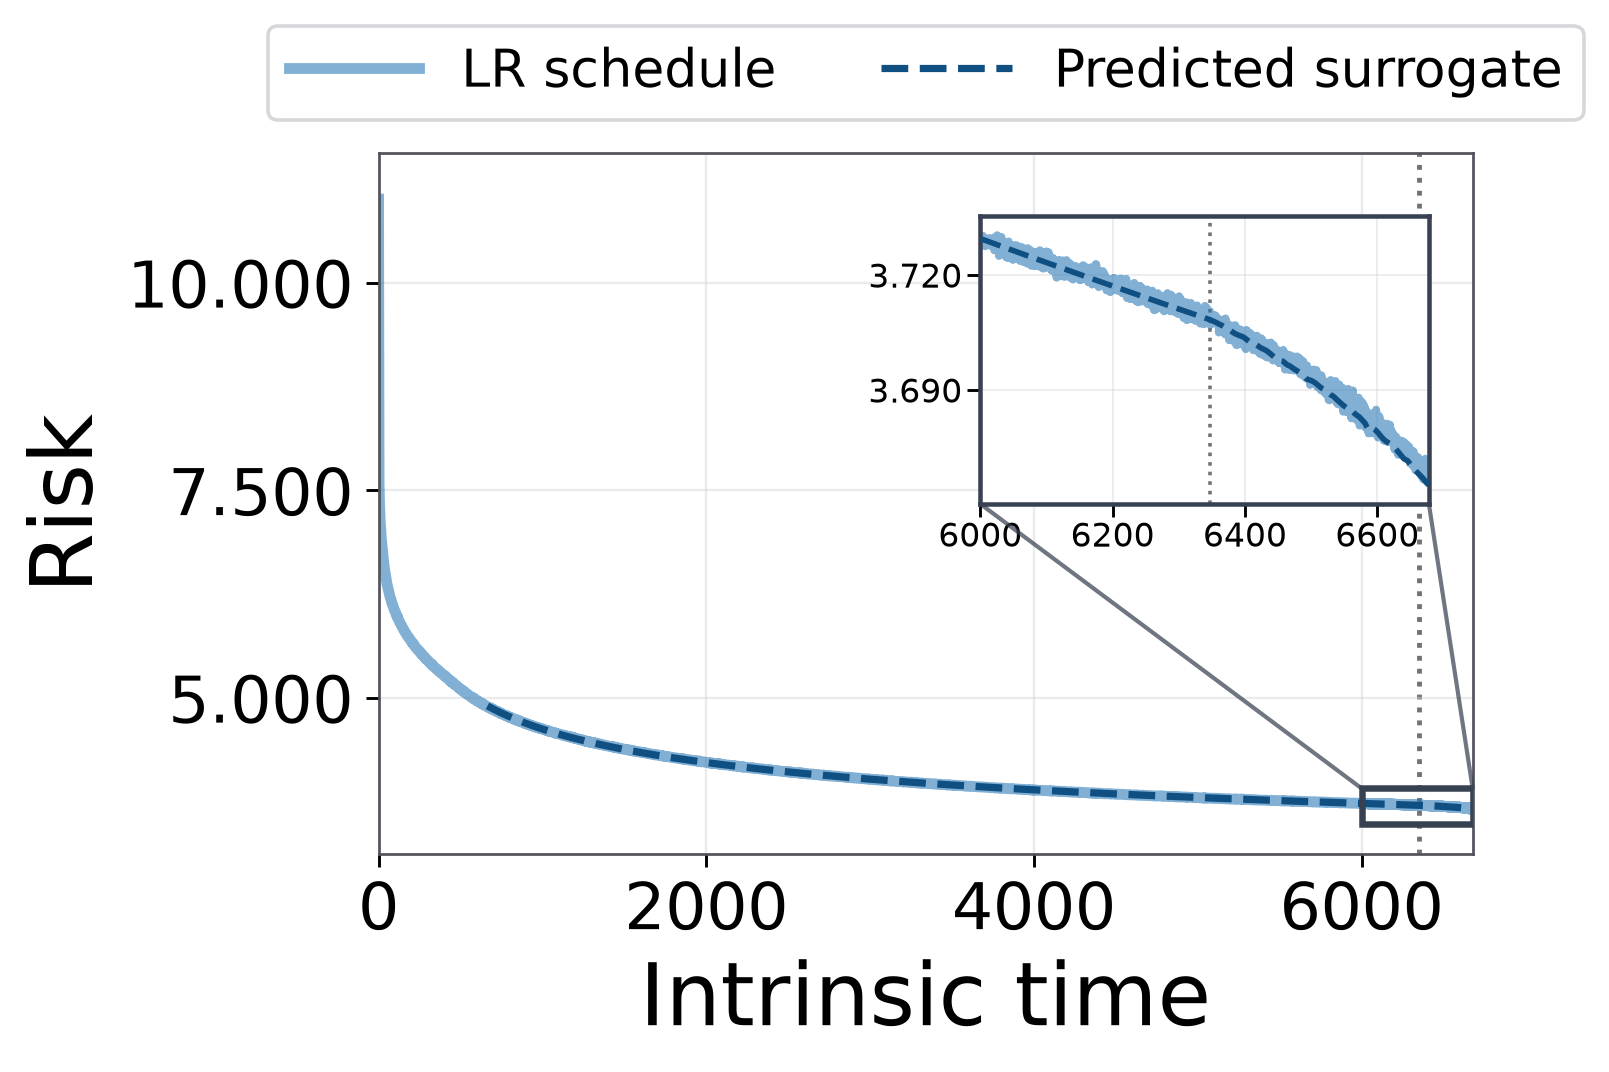
语言模型训练尚未结束,loss 曲线就可能已经显露出规律:在一段相当长的训练过程中,它可能按幂律下降。拟合已经走过的这段曲线,就能估计继续训练后,loss 还有多少下降空间。因此,不必等到训练结束,学习曲线就已经能帮助我们做判断。
把拟合曲线向后延伸很容易,难的是判断什么时候可以相信它。幂律趋势未必会一直持续;即使模型和数据不变,调整 learning rate 或 batch size,也可能改变下降指数。看似属于学习任务本身的曲线,其实也取决于训练方式。要预测接下来会发生什么,就需要理解这种依赖从何而来。
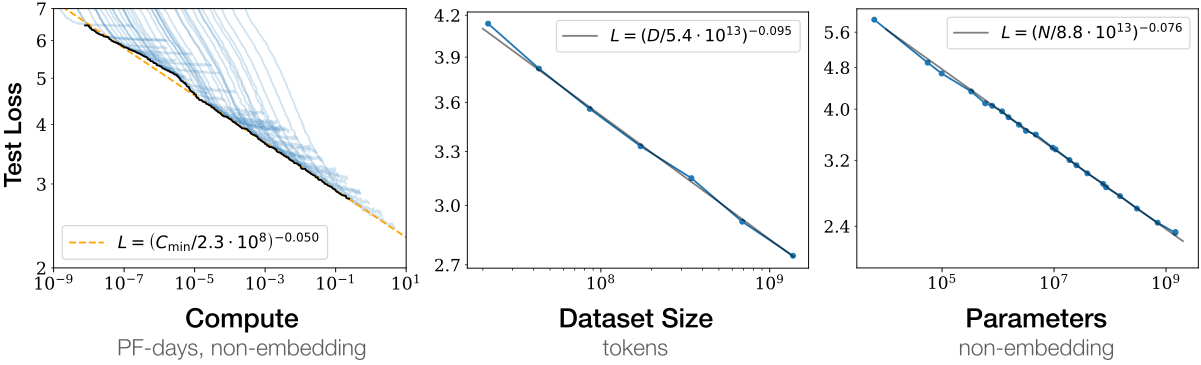
计算预算固定时,模型越大,能用于训练的 token 就越少。Chinchilla 用一个拟合公式描述这种权衡:一个具有 \(N\) 个参数、训练了 \(D\) 个 token 的模型,其最终 loss 近似为
\[L(N,D)\approx L_\infty+\frac{A_N}{N^\alpha}+\frac{A_D}{D^\beta}.\]其中,\(L_\infty\) 是拟合得到的 loss floor;另外两项分别描述模型规模和训练 token 数有限所带来的额外 loss,\(A_N,A_D\) 是拟合幅度,\(\alpha,\beta\) 是拟合指数。
对于 dense Transformer,训练计算量近似为 \(C\approx6ND\)。在每个计算预算下,选择使拟合 loss 最小的模型规模和 token 数,就得到了 compute-optimal frontier。
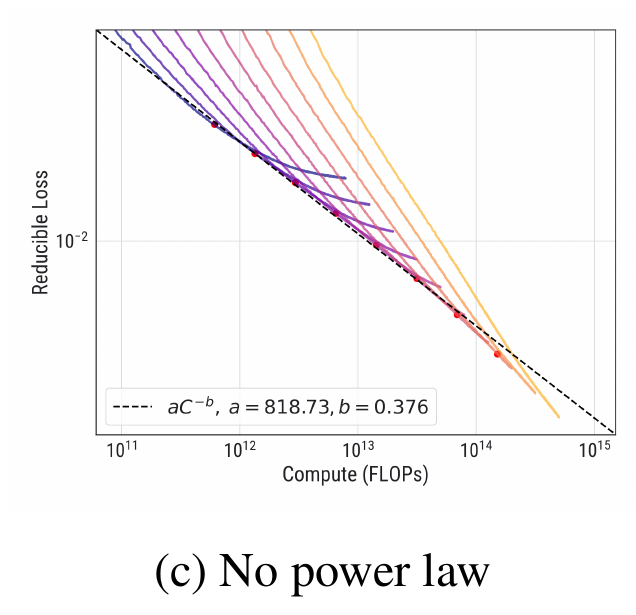
这些规律使幂律成为规划大规模训练的有用工具。但换一个任务或训练方案,幂律形式未必仍然成立。
在 Qiu 等人的合成回归实验中,MLP 学习一个频率分布呈指数衰减的目标时,得到的 compute–loss frontier 无法用幂律很好地描述。
训练方案同样重要。在 Porian 等人的语言模型实验中,带有拟合 loss floor 的幂律,在调优后的训练方案下能够较好地外推,但在其他方案下,外推效果明显变差。
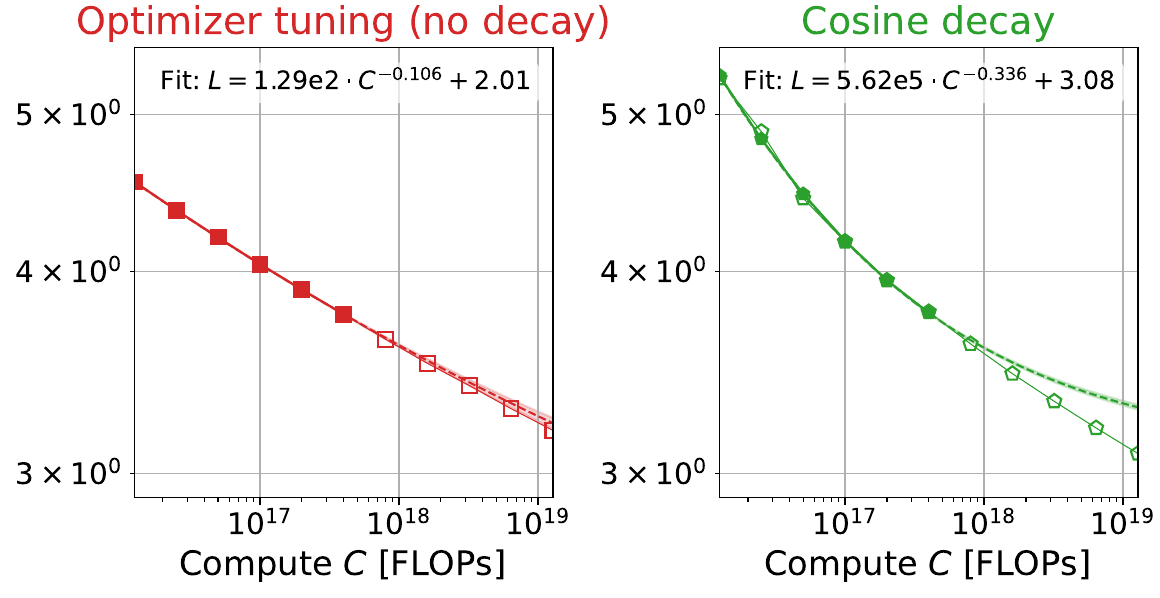
训练方式的影响不只体现在跨模型的前沿上,也能在单个模型的训练过程中看到。即使模型和数据都不变,改变 learning-rate schedule,也可能改变 loss 随训练步数下降的拟合幂律指数。
在某个训练阶段,原始 training loss 可以拟合为
\[L_{\mathrm{train}}(t)\approx a\,t^{-p},\]其中,\(t\) 是训练步数,\(a\) 是拟合幅度,\(p\) 是这一阶段的下降指数。比较不同 learning-rate schedule 下的训练,就能看到训练方式如何影响 \(p\)。
Mircea 等人比较了架构、数据和其他设置相同的两组独立训练:一组在 warmup 后使用 constant learning rate,另一组在 warmup 后使用 cosine decay。
比较两个面板中的 144M 模型:cosine decay 将训练后期的拟合指数从 0.023 提高到 0.036。拟合斜率不仅取决于模型和数据,也取决于训练 schedule。
一个共同的机制,需要同时解释幂律为何出现,以及数据与任务结构如何与训练方式相互作用。一个有用的检验是:在一种 schedule 下拟合响应,再不经重新拟合地预测另一种 schedule。对于随机梯度下降(SGD),我们可以从单次更新看起:每次更新都会改变参数,它的影响可能延续到后续更新,在 loss 中留下历史。
为什么 SGD 会留下记忆
训练历史保存在参数中,但单个 loss 值掩盖了其中的大部分信息。两次训练即使当前 loss 相同,对下一次更新的响应也可能不同。因此,仅用 loss 来描述训练,就必须考虑它的历史。
对于模型 \(f_\theta\),设其训练目标为 \(\mathcal L\),记 \(\eta_t\) 为 learning rate,\(B_t\) 为 batch size,\(\xi_t\) 为 minibatch 梯度误差。每次使用新采样的独立同分布样本时,SGD 可写为
\[\theta_{t+1} =\theta_t-\eta_t\nabla\mathcal L(\theta_t)-\eta_t\xi_t, \qquad \mathbb E_t[\xi_t]=0, \qquad \operatorname{Cov}_t(\xi_t)=\frac{\Sigma(\theta_t)}{B_t}.\]这里的期望以训练历史为条件,\(\Sigma\) 是单样本梯度协方差。因此,参数扰动 \(-\eta_t\xi_t\) 的方差尺度为 \(\eta_t^2/B_t\):减小 learning rate 或增大 batch size,都能减小扰动。对于后续 loss 而言,关键是之后的更新如何传播这一扰动。
小噪声展开让我们可以把这些影响加起来。记 \(F(n)\) 为无噪声的 validation loss,\(K(n,s)\) 为在第 \(n\) 次更新时对第 \(s\) 次更新注入噪声的响应,其中已除去方差尺度:
\[\mathbb E L_{\mathrm{val}}(\theta_n) \approx \underbrace{F(n)}_{\text{baseline learning}} +\sum_{s<n} \underbrace{\frac{\eta_s^2}{B_s}}_{\text{injected variance scale}} \underbrace{K(n,s)}_{\text{effect on the final loss}}.\]第一项对应从相同初始化出发、采用相同 learning-rate schedule 的全梯度更新;求和项汇总了 minibatch noise 的影响。这里的 \(K(n,s)\) 仍包含噪声随状态变化的强度,而不只是噪声的传播过程。这是 forcing–memory 分解的起点。
这个表达式本身还不能保证响应呈幂律。要理解它的形状,我们需要知道训练消除误差的速度。
推导细节:从 SGD 更新到 memory response
固定更新步数 \(n\)、初始化 \(\theta_0\) 和确定性的 schedule \((\eta_t,B_t)\)。令 \(\theta_t\in\mathbb R^p\) 为第 \(t\) 次更新前的参数。每次更新都使用从同一数据分布中新采样的独立同分布样本。假设下述展开所需的光滑性条件和矩界成立。
1. 采样噪声的大小。 对于模型 \(f_\theta\) 和单样本 loss \(\ell(f_\theta;z)\),记 \(\mathcal L(\theta)=\mathbb E_z[\ell(f_\theta;z)]\),\(g(\theta;z)=\nabla_\theta\ell(f_\theta;z)\)。在第 \(t\) 次更新中,令 \(z_{t,i}\) 为该批次中的第 \(i\) 个样本。minibatch 梯度 \(\widehat g_t\) 及其采样误差 \(\xi_t\) 为
\[\widehat g_t=\frac1{B_t}\sum_{i=1}^{B_t}g(\theta_t;z_{t,i}), \qquad \xi_t=\widehat g_t-\nabla\mathcal L(\theta_t).\]令 \(\mathbb E_t\) 表示以训练历史为条件的期望,\(\mathbb E\) 表示对所有批次取期望。定义单样本梯度协方差 \(\Sigma(\theta)=\operatorname{Cov}_z(g(\theta;z))\)。由样本的条件独立性可得
\[\mathbb E_t[\xi_t]=0, \qquad \mathbb E_t[\xi_t\xi_t^{\!\top}] =\frac1{B_t^2}\sum_{i=1}^{B_t}\Sigma(\theta_t) =\frac{\Sigma(\theta_t)}{B_t}.\]参数扰动为 \(h_t=-\eta_t\xi_t\),因此 \(\mathbb E_t\lVert h_t\rVert^2=\eta_t^2\operatorname{Tr}\Sigma(\theta_t)/B_t\)。这样就把依赖 schedule 的方差尺度 \(\eta_t^2/B_t\) 与依赖状态的梯度协方差区分开来。
2. 单次扰动如何经过后续更新传播。 定义全梯度更新映射 \(D_t\) 及其参考轨迹 \(\bar\theta_t\):
\[D_t(\theta)=\theta-\eta_t\nabla\mathcal L(\theta), \qquad \bar\theta_{t+1}=D_t(\bar\theta_t), \qquad \bar\theta_0=\theta_0.\]将扰动 \(h_s=-\eta_s\xi_s\) 仅注入第 \(s\) 次更新,其余步骤均使用全梯度更新。令 \(\delta_t^{(s)}\) 为相对于 \(\bar\theta_t\) 的位移。若 Hessian 局部 Lipschitz 连续,将两条轨迹的更新相减,并对 \(t\ge s+1\) 展开,可得
\[\begin{aligned} \delta_{t+1}^{(s)} &=D_t(\bar\theta_t+\delta_t^{(s)})-D_t(\bar\theta_t)\\ &=\left[I-\eta_t\nabla^2\mathcal L(\bar\theta_t)\right]\delta_t^{(s)} +O\!\left(\eta_t\|\delta_t^{(s)}\|^2\right). \end{aligned}\]从 \(\delta_{s+1}^{(s)}=-\eta_s\xi_s\) 出发,仅保留线性项,得到
\[\delta_n^{(s)}\approx-\eta_s A_{n-1}\cdots A_{s+1}\xi_s, \qquad A_t=I-\eta_t\nabla^2\mathcal L(\bar\theta_t).\]这里的 \(A_t\) 是沿参考轨迹的更新 Jacobian。矩阵乘积描述了后续更新如何改变原始扰动;空乘积为 \(I\)。
3. 扰动如何改变最终 loss。 令 \(L_{\mathrm{val}}\) 为 validation loss。定义 \(G_{n,s}(\theta)\) 为从参数 \(\theta\) 出发、自第 \(s\) 次更新起完成其余全梯度更新后得到的最终 validation loss:
\[G_{n,s}(\theta) =L_{\mathrm{val}}\!\left((D_{n-1}\circ\cdots\circ D_s)(\theta)\right), \qquad G_{n,n}(\theta)=L_{\mathrm{val}}(\theta).\]根据定义,\(G_{n,s}=G_{n,s+1}\circ D_s\)。
记 \(\Psi=D_{n-1}\circ\cdots\circ D_{s+1}\) 为从第 \(s\) 次更新后的参数到最终参数的映射,其坐标分量为 \(\Psi_i\)。于是 \(G_{n,s+1}=L_{\mathrm{val}}\circ\Psi\),由二阶链式法则可得
\[\begin{aligned} \nabla^2G_{n,s+1}(\theta) ={}&\left[\frac{\partial\Psi}{\partial\theta}(\theta)\right]^{\!\top} \nabla^2L_{\mathrm{val}}(\Psi(\theta))\,\frac{\partial\Psi}{\partial\theta}(\theta)\\ &+\sum_{i=1}^{p} \partial_i L_{\mathrm{val}}(\Psi(\theta))\,\nabla^2\Psi_i(\theta). \end{aligned}\]从 \(\bar\theta_{s+1}\) 出发,完成其余更新后到达 \(\bar\theta_n\),且 \(\frac{\partial\Psi}{\partial\theta}\) 等于 \(A_{n-1}\cdots A_{s+1}\)。代入可得
\[\begin{aligned} \nabla^2G_{n,s+1}(\bar\theta_{s+1}) ={}&(A_{n-1}\cdots A_{s+1})^{\!\top} \nabla^2L_{\mathrm{val}}(\bar\theta_n) (A_{n-1}\cdots A_{s+1})\\ &+\sum_{i=1}^{p} \partial_i L_{\mathrm{val}}(\bar\theta_n)\,\nabla^2\Psi_i(\bar\theta_{s+1}). \end{aligned}\]传播矩阵由此进入未来 loss 的曲率。第一项衡量 loss 对最终参数离散程度的响应。第二项刻画非线性更新引起的参数均值偏移:均值为零的扰动经过非线性传播后,均值未必仍为零。两者都有二阶贡献,因此都必须保留。
回到实际的 SGD 轨迹,定义 \(\theta_s^+=D_s(\theta_s)\),即第 \(s\) 次更新中完成全梯度部分后的状态。由于 \(\theta_{s+1}=\theta_s^+ +h_s\),取条件期望的 Taylor 展开给出
\[\begin{aligned} &\mathbb E_s\!\left[G_{n,s+1}(\theta_s^+ +h_s)-G_{n,s+1}(\theta_s^+)\right]\\ &\quad=\frac12\mathbb E_s\!\left[ h_s^{\!\top}\nabla^2G_{n,s+1}(\theta_s^+)h_s\right] +O\!\left(\eta_s^3\mathbb E_s\|\xi_s\|^3\right)\\ &\quad=\frac{\eta_s^2}{2B_s}\operatorname{Tr}\!\left[ \Sigma(\theta_s)\nabla^2G_{n,s+1}(\theta_s^+) \right] +O\!\left(\eta_s^3\mathbb E_s\|\xi_s\|^3\right). \end{aligned}\]线性项因 \(\mathbb E_s[h_s]=0\) 而消失;第二个等号使用了 \(\mathbb E_s[h_sh_s^{\top}]=\eta_s^2\Sigma(\theta_s)/B_s\)。高阶余项由未来 loss 在从 \(\theta_s^+\) 到 \(\theta_s^+ +h_s\) 的线段上的三阶导数控制。
4. 汇总所有更新的影响。 通过望远镜求和,中间的未来 loss 值相互抵消,剩下最终 SGD loss 与无噪声 baseline 之差:
\[\begin{aligned} L_{\mathrm{val}}(\theta_n)-G_{n,0}(\theta_0) &=\sum_{s<n}\left[G_{n,s+1}(\theta_{s+1})-G_{n,s}(\theta_s)\right]\\ &=\sum_{s<n}\left[ G_{n,s+1}(\theta_s^+ +h_s)-G_{n,s+1}(\theta_s^+) \right]. \end{aligned}\]取期望,并定义无噪声 baseline \(F(n)=G_{n,0}(\theta_0)\) 及响应系数
\[K(n,s) :=\frac12\mathbb E\!\left[ \operatorname{Tr}\!\left( \Sigma(\theta_s)\nabla^2G_{n,s+1}(D_s(\theta_s)) \right)\right].\]令 \(\mathcal E_n\) 汇总所有更新中高阶余项的期望。代入第 3 步的展开式,得到
\[\mathbb E L_{\mathrm{val}}(\theta_n) =F(n) +\sum_{s<n}\frac{\eta_s^2}{B_s}K(n,s) +\mathcal E_n.\]这个计算并未去掉先前噪声的影响:\(\theta_s\) 本身已经依赖于此前的所有批次。因此,定义 \(K(n,s)\) 时取的平均也包含了先前噪声如何改变第 \(s\) 次更新所处状态的影响。
5. 近似留下的误差。 对于所考虑的采样历史,令 \(M_{n,s}\) 为各条 Taylor 展开线段上 \(|\nabla^3G_{n,s+1}|\) 的一致上界。则
\[|\mathcal E_n| \le\frac16\sum_{s<n} M_{n,s}\eta_s^3\mathbb E\|\xi_s\|^3.\]忽略 \(\mathcal E_n\),就得到正文中的响应近似。在固定更新步数下,若将采样噪声乘以 \(\epsilon\),则在导数和三阶矩具有一致界的条件下,保留项的主导贡献是 \(\epsilon\) 的二次项,而余项为 \(O(\epsilon^3)\)。
这个计算说明了 \(K(n,s)\) 衡量的是什么:第 \(s\) 次更新加入的噪声如何影响第 \(n\) 次更新的 loss,其中也包括训练过程中所处状态的影响。要用带正衰减指数的幂律描述这一响应随时间的变化,还需要进一步的建模。接下来的几节将解释谱模型如何产生这样的规律,以及 LLM 实验如何检验它能否预测新 schedule 下的 loss。
不同方向的学习速度不同
训练消除某些方向上误差的速度,比另一些方向更快。对于特征固定、输出权重可训练的模型,我们可以显式算出这些速度,Paquette 等人对计算最优缩放的分析就采用了这一思路。
考虑模型 \(f_a(x)=a^\top\phi(x)\),其特征 \(\phi\) 固定,权重 \(a\) 可训练,并使用 squared loss。用 \(\rho_{j,t}\) 表示沿 Hessian 矩阵某个特征向量方向的参数误差,对应的特征值为 \(\lambda_j\)。当全梯度更新的步长较小时,
\[\rho_{j,t}\approx\rho_{j,0}e^{-\lambda_jT_t}, \qquad T_t=\sum_{s<t}\eta_s.\]这里的时钟 \(T_t\) 称为 intrinsic time。正特征值越大,学习就越快;特征值越小,误差就越持久,其学习时间与 \(1/\lambda_j\) 成正比。
loss 是各个方向上平方误差的加权和。如果某个方向上的初始误差几乎为零,即使这个方向学得很慢,它对 loss 的贡献也很小。学习速度和对 loss 的重要性,是两回事。
在我们的 Gaussian random feature model 中,SGD 相对于无噪声目标的期望平方预测误差 \(R_t\) 满足如下精确递推:
\[R_t=F_t+\sum_{s<t}K_{t,s}\bigl(R_s+\sigma^2\bigr).\]这里 \(\sigma^2\) 是 label noise 的方差。分组方式发生了变化:\(F_t\) 描述初始误差的传播,其中包含 batch size 有限时的采样修正,因此它并不是无噪声 baseline \(F(n)\)。kernel \(K_{t,s}\) 包含 \(\eta_s^2/B_s\),而产生新噪声的误差则由 \(R_s+\sigma^2\) 显式给出。前面的 \(K(n,s)\) 包含依赖于状态的噪声强度,却将 \(\eta_s^2/B_s\) 留在 kernel 外。这两个公式都可以作 forcing–memory 分解,但其中 \(F\) 和 \(K\) 的定义并不相同。
bias–variance 提供了对同一动力学的另一种分组方式。考虑模型能够表示无噪声目标的情形,并假设 label noise 独立于输入且均值为零。沿用 Zou、Wu 等人按误差来源作出的分解,用 \(B_t\) 表示 clean-label SGD 所产生的误差,用 \(V_t\) 表示从零初始误差出发、由 label noise 驱动的误差。仅在这段比较中,\(B_t\) 表示 bias,而非 batch size。在每一步,
\[\begin{aligned} R_t &=\underbrace{F_t+\sum_{s<t}K_{t,s}B_s}_{\text{source bias }B_t} +\underbrace{\sum_{s<t}K_{t,s}(V_s+\sigma^2)}_{\text{source variance }V_t}\\[6pt] &=\underbrace{F_t}_{\text{forcing}} +\underbrace{\sum_{s<t}K_{t,s}(B_s+V_s+\sigma^2)}_{\text{memory}}. \end{aligned}\]第一行区分误差的来源:是初始误差及其采样效应,还是 label noise 及其后续效应。第二行则将 forcing 项与累积的历史影响分开。尤其是,\(\sum_{s<t}K_{t,s}B_s\) 在第一行中属于 bias,在第二行中却属于 memory 项。使用干净标签会令 \(V_t=0\),但不会消除这部分 memory 项。这两种分解只是对同一组效应作了不同的归类;memory 项并不等同于 label-noise variance。
推导细节:从 squared loss 到学习时间
1. 从 squared loss 到梯度。设 \(\phi(x)\) 是输入 \(x\) 的固定特征向量,\(y\) 是其目标,\(a\) 是可训练权重。定义 population squared loss 及其 Hessian 矩阵:
\[\mathcal L(a)=\frac12\mathbb E\!\left[(a^\top\phi(x)-y)^2\right], \qquad H=\mathbb E[\phi(x)\phi(x)^\top].\]对于极小点 \(a_\star\),条件 \(\nabla\mathcal L(a_\star)=0\) 给出 \(\mathbb E[\phi(x)y]=Ha_\star\)。因此
\[\nabla\mathcal L(a) =\mathbb E\!\left[\phi(x)(a^\top\phi(x)-y)\right] =H(a-a_\star).\]梯度就是剩余参数误差经 \(H\) 变换后的结果。对于固定特征下的 squared loss,这是一个精确恒等式。
2. 从梯度到误差动力学。先考虑不含 minibatch noise 的全梯度训练。设 learning rate 为 \(\eta_t\),参数误差为 \(e_t=a_t-a_\star\),更新可以写成
\[\begin{aligned} a_{t+1}&=a_t-\eta_t\nabla\mathcal L(a_t),\\ e_{t+1}&=e_t-\eta_tHe_t=(I-\eta_tH)e_t. \end{aligned}\]设 \((\lambda_j,u_j)\) 构成对称矩阵 \(H\) 的一组标准正交特征系统,并定义 \(\rho_{j,t}=u_j^\top e_t\)。将更新投影到 \(u_j\) 上,得到
\[\begin{aligned} \rho_{j,t+1} &=u_j^\top(I-\eta_tH)e_t\\ &=(1-\eta_t\lambda_j)\rho_{j,t}, \qquad Hu_j=\lambda_j u_j. \end{aligned}\]沿 \(u_j\) 方向,梯度等于剩余误差的 \(\lambda_j\) 倍。因此,在小步长情形下,一次更新会消除该误差中 \(\eta_t\lambda_j\) 的比例。
3. 从递推关系到学习时间尺度。从初始误差 \(\rho_{j,0}\) 开始迭代,得到
\[\rho_{j,t} =\rho_{j,0}\prod_{s<t}(1-\eta_s\lambda_j).\]当 \(\eta_s\lambda_j\ll1\) 时,利用 \(\log(1-x)\approx-x\),可以得到用 intrinsic time 表示的近似:
\[\rho_{j,t}\approx\rho_{j,0}e^{-\lambda_jT_t}, \qquad T_t=\sum_{s<t}\eta_s.\]对于 \(\lambda_j>0\),用 \(T_{\mathrm{learn},j}\) 表示将误差幅度缩小固定倍数所需的 intrinsic time,用 \(t_{\mathrm{learn},j}\) 表示对应的更新次数。当 learning rate 固定为 \(\eta\) 时,
\[T_{\mathrm{learn},j}\asymp\frac1{\lambda_j}, \qquad t_{\mathrm{learn},j}\asymp\frac1{\eta\lambda_j}.\]特征值越大,学习时间越短;特征值越小,误差越持久。在时刻 \(T\),满足 \(\lambda_jT\gg1\) 的模态已经大幅衰减,而满足 \(\lambda_jT\ll1\) 的模态仍接近初始值。
4. 从各方向的误差到 loss。squared loss 对应的 excess loss 为
\[\begin{aligned} \mathcal L(a_t)-\mathcal L(a_\star) &=\frac12e_t^\top He_t =\frac12\sum_j\lambda_j\rho_{j,t}^2\\ &\approx\frac12\sum_j\lambda_j\rho_{j,0}^2e^{-2\lambda_jT_t}. \end{aligned}\]特征值决定衰减速度,各方向上的初始误差则决定其在 loss 中的权重。这就是为什么仅知道特征值还不够:我们还需要知道哪些方向对目标重要。SGD 中的 minibatch 采样会不断引入新误差;上面的全梯度计算单独刻画了已有误差如何衰减。
这些学习速度何时会产生幂律?
假设目标在某个学习缓慢的方向上几乎没有分量,那么这个方向上就几乎没有需要学习的信号。但 minibatch 采样仍然可能在这里引入误差,而且这些误差需要很长时间才会消失。
在下面的例子中,谱服从幂律,但目标几乎不使用其中的慢方向。forcing 项的消失速度快于任意负幂,SGD loss 却仍然保留着幂律尾部。剩下的是对 minibatch noise 的记忆。
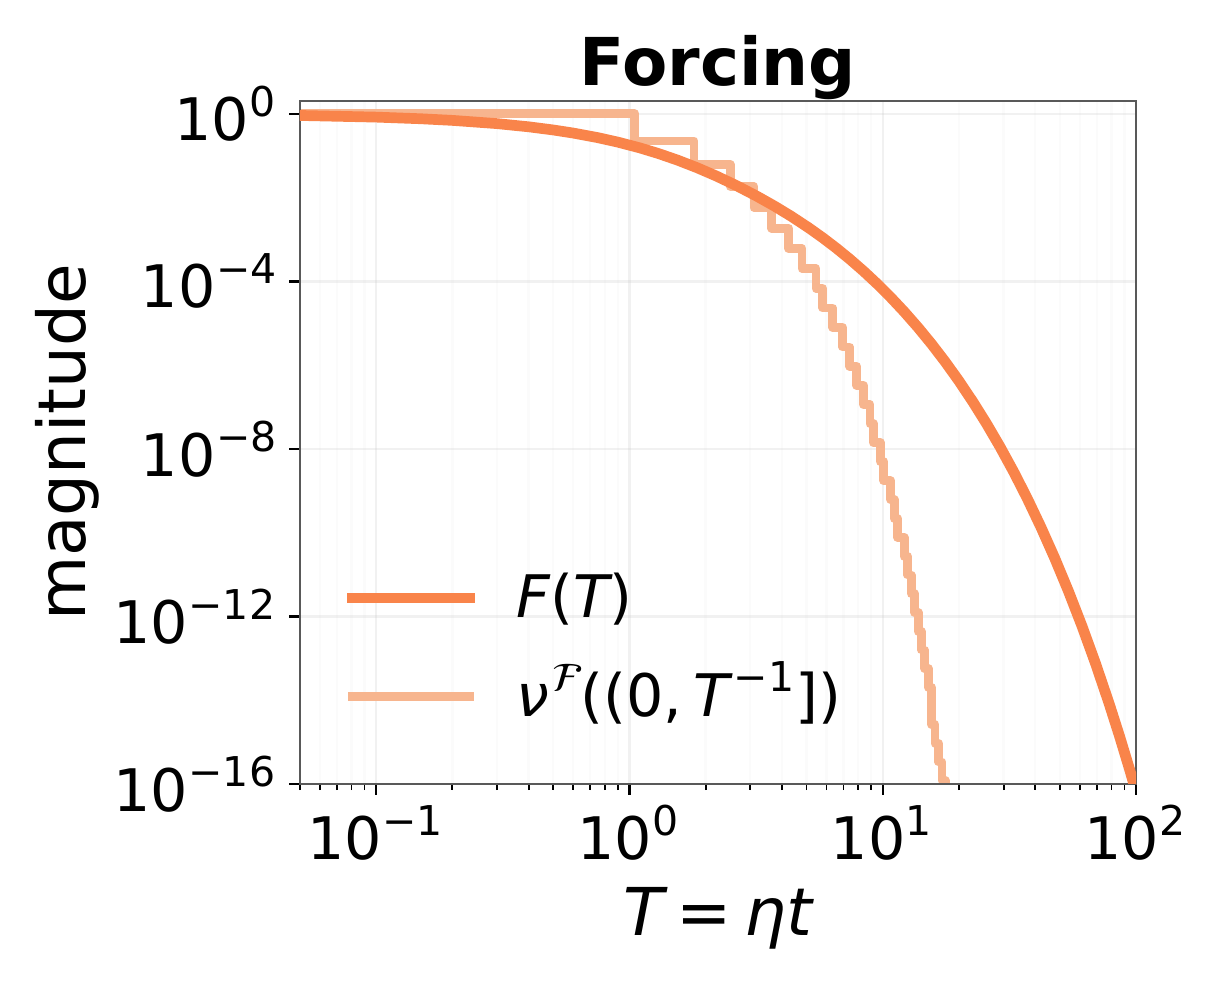
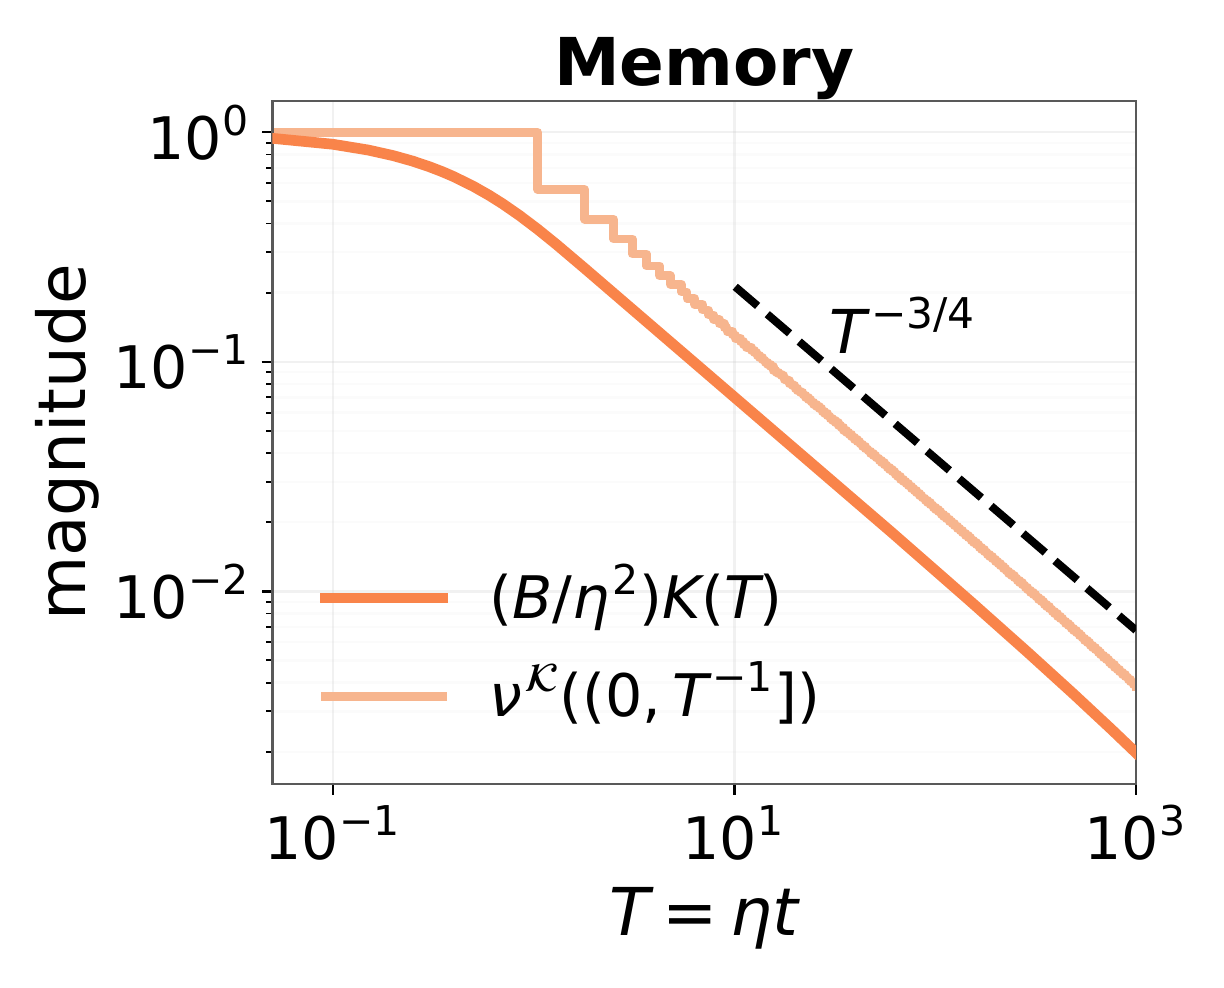
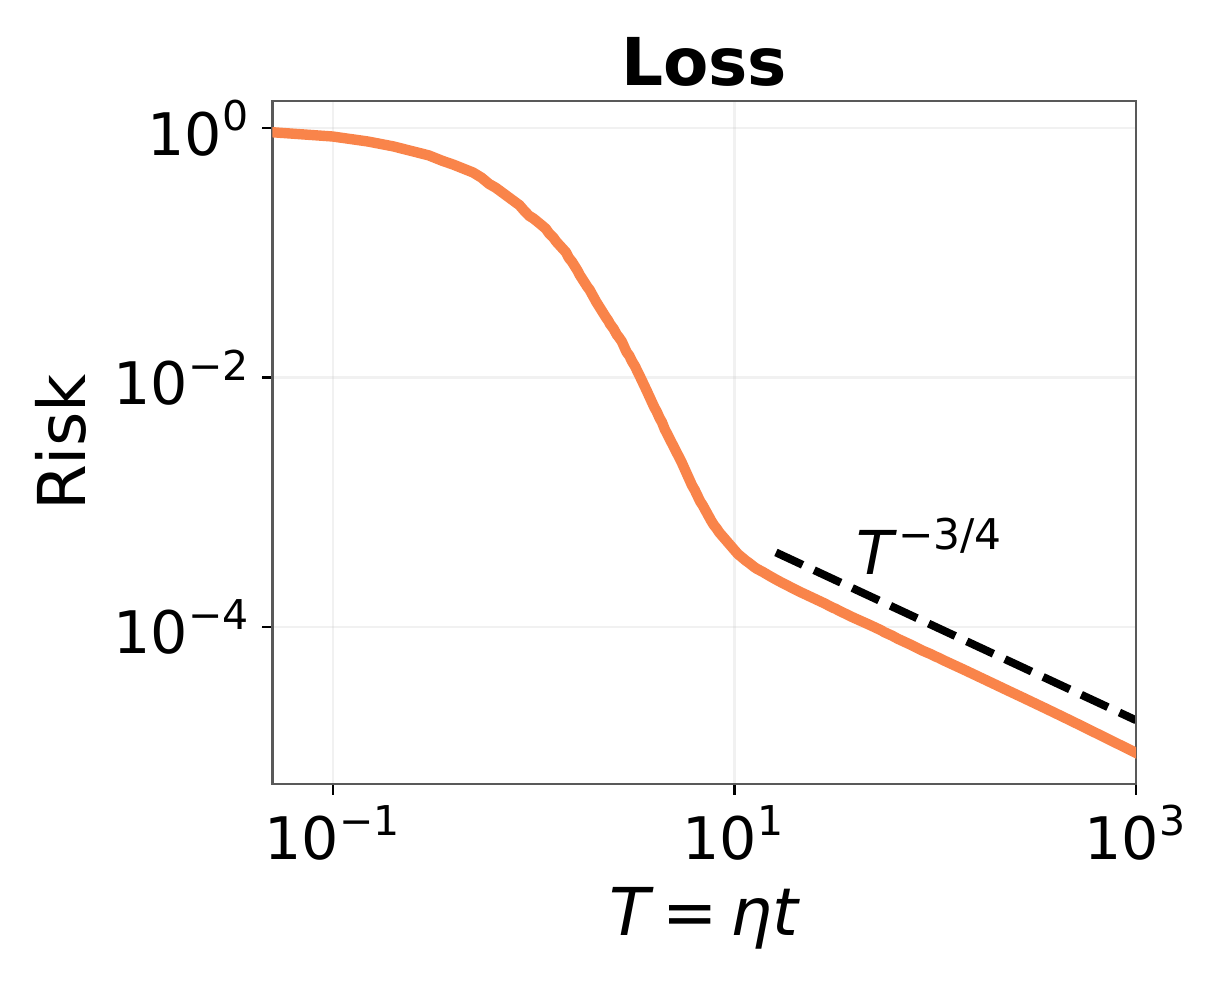
loss 衰减缓慢,并不一定意味着信号学得慢。forcing 项与 memory 项使用相同的衰减速度,却赋予这些速度不同的权重。仅凭拟合出的 loss 指数,无法判断哪一部分控制着曲线。
随着训练继续,快方向逐渐消退,慢方向开始占主导。在时刻 \(T\),剩余贡献主要来自满足 \(\lambda\lesssim1/T\) 的方向。因此,我们需要分别累加这些方向在 forcing 项和 memory 项中的权重。
在这个模型中,固定特征为 \(\phi(x)=W^\top x\),无噪声目标为 \(x^\top\theta^\star\),其中随机特征矩阵 \(W\) 和目标参数 \(\theta^\star\) 均固定。用 \(\widehat\lambda_j\) 和 \(\widehat u_j\) 表示 \(\Lambda^{1/2}WW^\top\Lambda^{1/2}\) 的特征值及单位特征向量,其中 \(\Lambda\) 是输入协方差。从零输出权重出发,两种累积权重分别为
\[\begin{aligned} \nu_W^{\mathcal F}((0,x]) &=\sum_{0<\widehat\lambda_j\le x} \left|\left\langle\widehat u_j,\Lambda^{1/2}\theta^\star\right\rangle\right|^2,\\ \nu_W^{\mathcal K}((0,x]) &=\sum_{0<\widehat\lambda_j\le x}\widehat\lambda_j^2. \end{aligned}\]如果特征值不超过 \(x\) 的累积权重按 \(x^q\) 缩放,那么时刻 \(T\) 剩下的贡献就具有 \((1/T)^q=T^{-q}\) 的量级:训练已将截断位置降到了 \(x\sim1/T\)。这就解释了为什么各个方向上的指数衰减,加在一起可以形成幂律。
对于恒定 schedule,用 \(F_W\) 表示这一 random feature model 的 forcing 项,用 \(F_{W,>0}\) 表示其中高于 loss floor 的部分,用 \(K_W\) 表示依赖于延迟的 kernel。下面用 intrinsic time 表示这些函数。将 \(K_W\) 乘以 \(B/\eta^2\),就去掉了其噪声注入尺度。理论还给出了反向推论:在大宽度、长时间极限下,一个分量若呈幂律衰减,其对应的累积谱权重就必须具有匹配的指数。示意地写成:
\[\begin{aligned} \nu_W^{\mathcal F}((0,x])\propto x^{q_{\mathcal F}} &\quad\Longleftrightarrow\quad F_{W,>0}(T)\propto T^{-q_{\mathcal F}},\\ \nu_W^{\mathcal K}((0,x])\propto x^{q_{\mathcal K}} &\quad\Longleftrightarrow\quad \frac{B}{\eta^2}K_W(T)\propto T^{-q_{\mathcal K}}. \end{aligned}\]正指数 \(q_{\mathcal F}\) 和 \(q_{\mathcal K}\) 分别描述 forcing 项与 memory 项。单个特征值不必服从幂律;真正重要的是它们的加权总量。
三类记忆
如果每次扰动都会消退,我们最终能否忽略遥远的过去?上面的记忆曲线只追踪一次噪声注入,但 SGD 每一步都会加入噪声。这些响应会累积起来。
以 intrinsic time 计,用 \(k(v)\) 表示经过延迟 \(v\) 后的归一化 memory response:对于作为参照的恒定 schedule,\(k(T)=(B/\eta^2)K_W(T)\)。噪声注入强度单独给出。当各次注入具有相同权重时,累积响应可能有两种表现:
- 响应消退得足够快,使其总量趋于一个有限值。这是 integrable memory(IM),对应 \(q_{\mathcal K}>1\)。
- 每次响应都会消退,但速度太慢,无法使总量稳定下来。这是 long memory(LM),对应 \(0<q_{\mathcal K}<1\)。累积记忆随时间跨度持续增长。
在边界 \(q_{\mathcal K}=1\) 处,累积记忆按对数增长。即使没有任何一次扰动永久保留,总量也仍然可以持续增长。
Finite bulk(FB)需要单独处理:其响应仍然依赖模型宽度,无法用一个与宽度无关的正衰减指数来描述。
更细的区域划分比较了 forcing 项与 memory 项的衰减速度,以及 forcing 项尾部的时间积分是否有限。
下面两张图将这些行为与学习问题联系起来。左图使用响应指数;右图使用一个具体的谱和目标:
\[\lambda_j=j^{-2\alpha}, \qquad |\theta_j^\star|=j^{-\beta}.\]这里 \(\lambda_j\) 是按顺序排列的数据协方差特征值,\(\theta_j^\star\) 是对应的目标系数。\(\alpha\) 越大,谱越陡;\(\beta\) 越大,目标在慢方向上的权重越小。
在目标能量有限的 LM/IM 区域内,指数为
\[q_{\mathcal F}=\frac{2\alpha+2\beta-1}{2\alpha}, \qquad q_{\mathcal K}=2-\frac{1}{2\alpha}.\]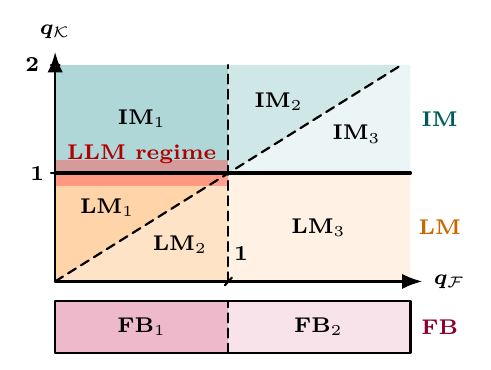
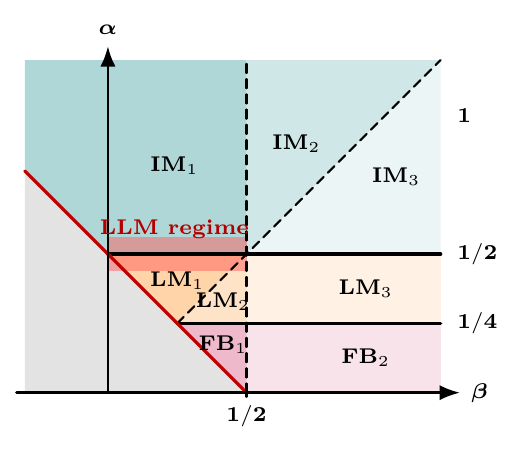
这些区域区分的是 forcing 项与 memory 项如何传播,并不代表八个固定的 loss 指数。训练 schedule 会改变历次噪声注入的强度。这些响应的累积又会怎样重塑观测到的曲线?
训练 schedule 如何改变响应
Learning rate 衰减常常会让训练曲线发生明显变化:原本缓慢下降的 loss 开始加速下落。在 warmup–stable–decay(WSD)训练中,learning rate 在 warmup 后保持不变,直到最后的衰减阶段。观察下面 MiniCPM 实验中的灰绿色曲线:衰减一开始,原先平缓的下降就变成了陡降。同样的现象出现在多个不同的训练阶段。
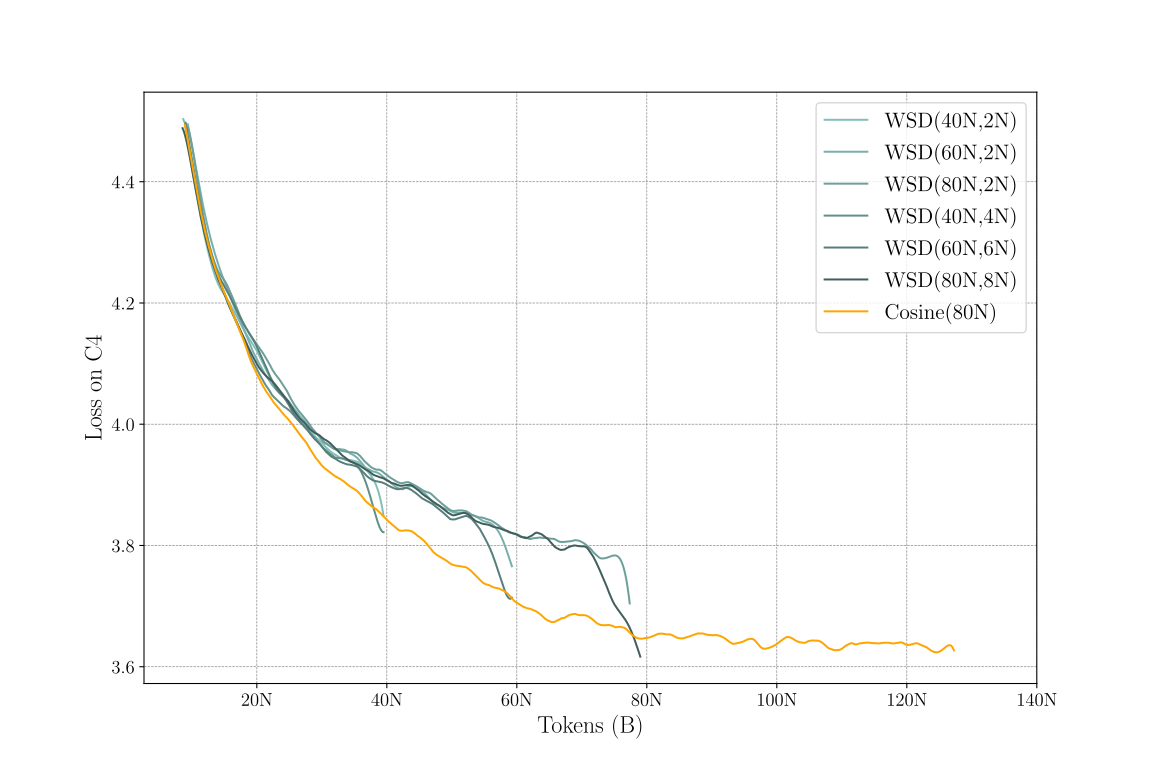
这些向下的拐点看起来像是降低 learning rate 让模型学得更快了。但 loss 下降更快,未必意味着模型更快地学到了目标:减少随机更新造成的误差同样会降低 loss。究竟是哪一种效应解释了这次下降?如果退火确实有帮助,为什么不能用更激进的 schedule 让 loss 不断加速下降?
要区分这两种效应,我们从普通 SGD 出发,回到 intrinsic time。降低 learning rate 既会缩短全梯度更新的步长,也会减小更新噪声;增大 batch size 则能在不缩短这一步长的情况下减小噪声。对应的时钟以及 batch size 与 learning rate 的比值为
\[T_t=\sum_{s<t}\eta_s, \qquad r_t=\frac{B_t}{\eta_t}.\]一次更新让时钟前进 \(\eta_t\),并注入尺度为 \(\eta_t^2/B_t\) 的方差。因此,\(1/r_t\) 是每单位 intrinsic time 的噪声尺度。用 \(r(T)\) 表示沿这一时钟变化的比值。
这将增大 batch size 与衰减 learning rate联系了起来:两者都会降低每单位 intrinsic time 的噪声。由于先前的噪声仍可能影响 loss,我们必须匹配整个比值路径,而不仅是它的终值。
回到幂律 random feature model,LM 和 IM 的 scaling law 可以写成连续形式
\[R(T)\asymp F(T)+ \int_0^T \frac{F(u)+\sigma^2}{r(u)} \,k(T-u)\,\mathrm du.\]这里,\(R\) 是预测风险,\(F\) 是 random feature model 的 forcing 项,其中包含有限宽度带来的 loss floor。精确递推式中反馈的是 \(R_s+\sigma^2\)。在 LM/IM 的 schedule 与稳定性假设下,计入反复反馈后,可得到上式中使用 \(F(u)+\sigma^2\) 的比较关系,允许相差乘法常数。这并不等于令 \(R=F\)。
即使没有 label noise,剩余的预测误差也会产生 minibatch noise;label noise 会在此基础上继续增加噪声。比值 \(r(u)\) 控制每单位 intrinsic time 的噪声注入强度,现在它被写在归一化 kernel \(k(T-u)\) 之外;这个 kernel 描述每次注入的噪声有多少会留存到 \(T\) 时刻。
来看一个具体例子:在有限宽度带来的 loss floor 尚未产生显著影响时,取一个满足 \(F(T)\asymp T^{-1/2}\) 和 \(k(T)\asymp T^{-3/2}\) 的 IM 区域。选择 \(r(T)\propto(1+T)^\vartheta\),并使其整体尺度足够大,以保证反馈稳定。
在积分中令 \(\sigma^2=0\),仍会留下由剩余预测误差产生的 minibatch noise。对下面三种 schedule,这部分贡献比 forcing 项衰减得更快,因此 clean-label SGD 的 loss 具有 \(T^{-1/2}\) 的量级。其衰减指数因而为 \(q_0=1/2\):在这里,它等于 \(q_{\mathcal F}\),但一般情况下并非如此。
现在,为每次运行加入相同的 label noise 方差 \(\sigma^2>0\)。在 IM 中,与相同 schedule 下的 clean-label SGD 相比,额外 loss 的量级为 \(T^{-\min\lbrace\vartheta,3/2\rbrace}\)。衰减较慢的那一项决定总 loss。忽略常数因子,三种 schedule 分别给出:
| 比值 \(r(T)\) 的增长 | label noise 带来的额外 loss | 总 loss |
|---|---|---|
| \(T^{1/4}\) | \(T^{-1/4}\) | \(T^{-1/4}\) |
| \(T\) | \(T^{-1}\) | \(T^{-1/2}\) |
| \(T^2\) | \(T^{-3/2}\) | \(T^{-1/2}\) |
第一行中,label noise 改变了观测到的指数;第二行中,它的影响消退得足够快,因此保留了 clean-label SGD 的指数。最后一行达到了 memory ceiling:继续增大 \(\vartheta\),也无法让额外 loss 比早先噪声注入留下的 \(T^{-3/2}\) 尾部衰减得更快。此时,总 loss 已经受 forcing 项限制,维持在 \(T^{-1/2}\) 的量级。
当 memory 项和比值增长都服从幂律时,将额外 loss 与 clean-label SGD 的 loss 比较,会得到三种结果:
- 破坏:额外 loss 不以正幂次衰减。
- 改变:额外 loss 比 clean-label SGD 的 loss 衰减得更慢,从而决定一个新的指数。
- 保持:额外 loss 的衰减至少同样快,因此 clean-label SGD 的指数保持不变。
下图比较了 clean-label SGD 的 excess-loss 指数 \(q_0\)(描述 loss 高于其 floor 的部分按 \(T^{-q_0}\) 衰减)与比值增长指数 \(\vartheta\)(由 \(r(T)\sim T^\vartheta\) 定义)。
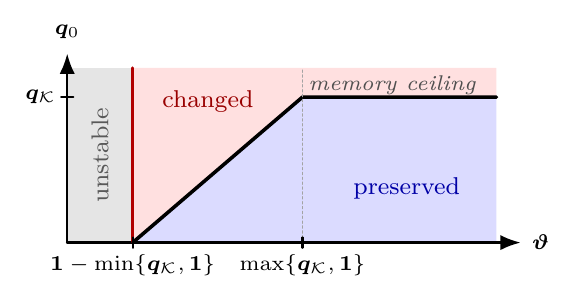
固定 \(q_0\),沿水平方向向右移动,也就是增大 \(\vartheta\)。如果 \(q_0<q_{\mathcal K}\),我们最终会从改变区域进入保持区域:此时额外 loss 的衰减速度至少与 clean-label SGD 的 excess loss 一样快。如果 \(q_0>q_{\mathcal K}\),无论向右移动多远,这条水平线始终在 memory ceiling 之上。额外 loss 的衰减指数以 \(q_{\mathcal K}\) 为上限,因此更激进地抑制噪声,也无法恢复 clean-label SGD 的指数。
从 schedule 规律到 schedule 设计
即使指数存在上限,仍有一个实际选择需要做:在数据预算和终点 intrinsic time \(T\) 固定时,额外样本应该用在哪些时刻?如果某个时刻的噪声原本会一直影响到训练结束,那么在那里投入样本以抑制噪声,就更有价值。
在 LM/IM 响应模型中,平衡噪声源的强度及其未来影响,可以得到最优比值
\[r_T^\star(u) \propto \sqrt{k(T-u)\bigl[F(u)+\sigma^2\bigr]}.\]数据预算决定归一化常数。平方根平衡了当前产生的噪声与它的未来影响:有些早期扰动到训练结束时已经消退,另一些则仍然有影响。仅看当前 loss,无法捕捉这一区别。Bordelon 与 Mori 的最优控制分析为 learning rate 设计提供了一条互补的路径。
Learning rate schedule 与 batch size schedule 可以实现同一条比值路径。进一步优化训练时长和模型宽度,就能得到依赖于不同区域的数据与计算 scaling law。这也连接了开篇提到的两个尺度:单次训练的学习曲线,决定了我们在不同模型之间进行选择时能够达到什么结果。
从理论走向 LLM 预训练
与前面的固定特征模型不同,LLM 的表示会持续变化。但要描述它的 loss,未必需要复现参数的每一次变化。
这留下了一种更广泛的可能性:forcing–memory 分解可能是 SGD 的一种粗粒度响应规律,而不只是对线性模型的描述。不同的参数轨迹可能产生相似的 loss 响应。改变训练 schedule,就能检验这种响应是否可以迁移。
同一条比值路径的两种实现
先保持比值路径相同,但用不同方式实现它:一次运行固定 batch size、降低 learning rate,另一次运行固定 learning rate、增大 batch size。将两者的时钟和比值路径匹配起来。
我们用普通 SGD,在 6.5B 个 OpenWebText token 上训练了一个 300M 的 LLM,进行了这一比较。所有运行共享前 80% 的 token 预算,然后从同一个 checkpoint 分支,使用剩下的 20%。在固定 batch size 的运行中,WSD 在最后这段训练中逐渐降低 learning rate,而 8-1-1 则分为两个 learning rate 更低的阶段,每个阶段占 10%。如果 intrinsic time 和比值路径捕捉到了 schedule 的主要影响,那么每组 learning rate/batch size 配对的运行都应沿着近乎相同的 loss 曲线前进。

这正是我们观察到的现象。成对的曲线以 optimizer step 为横轴时相互分离,以 intrinsic time 为横轴时则近乎重合。当时钟和比值路径匹配时,改变 learning rate 或 batch size 会产生非常相近的 loss 响应。
拟合一种 schedule,预测另一种
上面的配对运行共享同一条比值路径。更严格的检验是改变这条路径:从 8-1-1 的突然降档中学到的响应,能否预测 WSD 的逐渐衰减?
对于 LLM 的 validation loss,我们保留 forcing–memory 分解的结构,但通过拟合确定各分量函数,而不直接使用 random feature model 中的精确量。沿着 Li 等人的 functional scaling law 方法,我们采用以下七参数 surrogate:
\[\widehat L(T) =L_\infty+A_{\mathcal F}(1+T)^{-q_{\mathcal F}} +\int_0^T \frac{A_0+A_1(1+u)^{-q_{\mathcal F}}}{r(u)} \bigl(1+c_{\mathcal K}(T-u)\bigr)^{-q_{\mathcal K}} \,\mathrm du.\]前两项构成一条拟合得到的 baseline,而不是单独测量得到的无噪声轨迹。积分项描述早先噪声按其留存程度加权后的影响;其中噪声源的幅度 \(A_0,A_1\) 是自由参数,并不由 \(L_\infty\) 和 \(A_{\mathcal F}\) 固定。各参数描述有效响应,而 \(r(u)\) 提供 schedule。
我们固定 \(q_{\mathcal K}=1\),用固定 batch size 的 8-1-1 运行所测得的原始 validation loss 拟合其余六个参数。随后固定所有参数,仅将比值路径替换为 WSD 的路径。拟合过程中没有使用任何 WSD loss。
预测曲线跟随了 WSD 实测 validation loss 的变化,也捕捉到了它发生在不同时间的下降。这一变化来自输入 schedule 的改变,而不是为了拟合另一条运行曲线而调整了响应。
8-1-1 拟合的 RMSE 为 \(1.31\times10^{-3}\) nats/token,固定所有参数后的 WSD 预测的 RMSE 为 \(1.58\times10^{-3}\)。
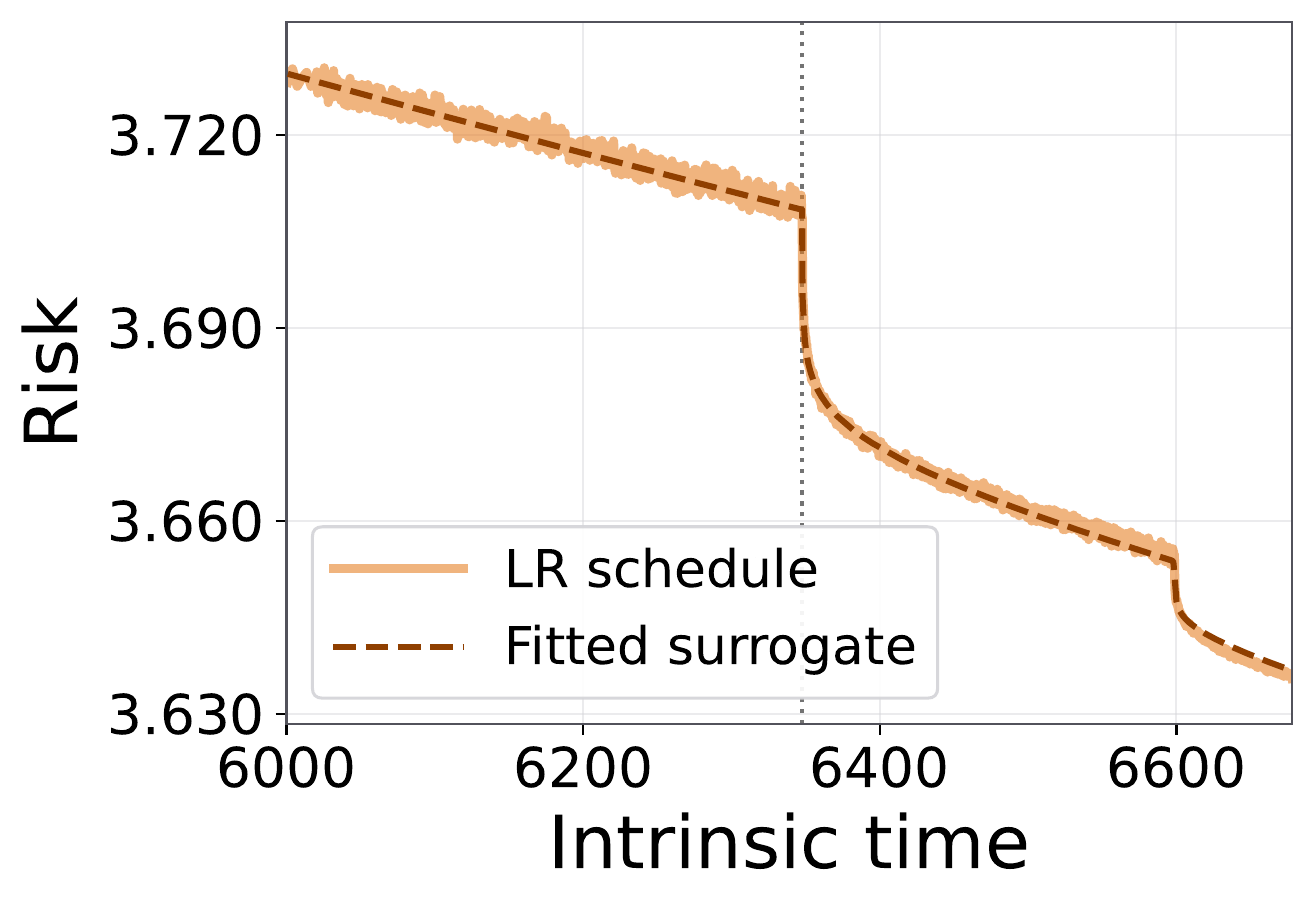
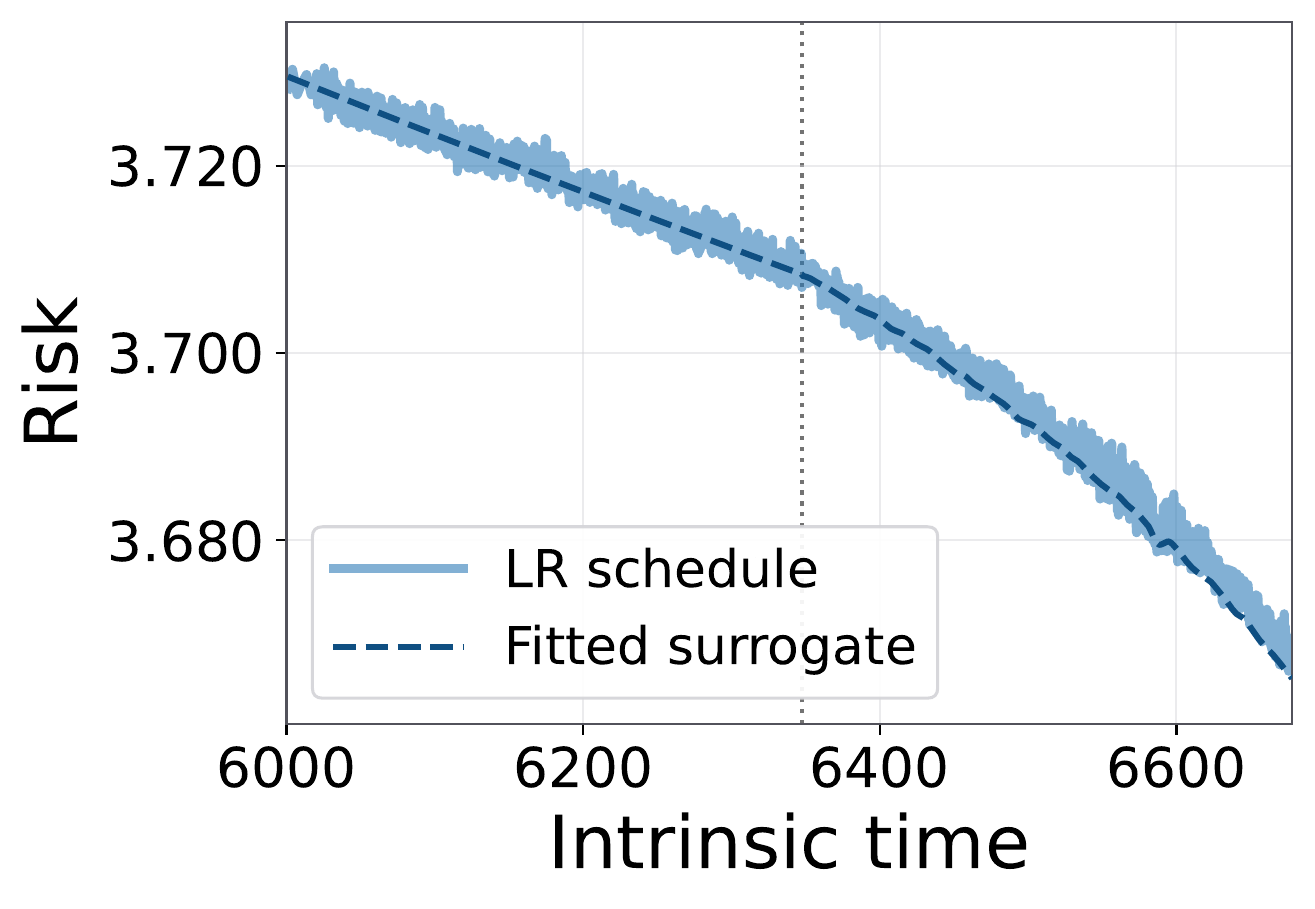
与分别拟合两条曲线相比,这样的检验更能揭示模型的预测能力。
一个学习曲线模型,应当通过预测训练发生变化后的结果来赢得我们的信任。
这里,同一个响应描述了两种不同的噪声注入历史。
实验与 surrogate 细节
训练与匹配。初步的 30M 实验从一个已充分训练的普通 SGD checkpoint 出发,沿十一条比值路径继续训练,全部在相同的 intrinsic time 结束。在 300M 比较中,每组 learning rate/batch size 配对的运行都以若干次更新为一组,匹配数据量、intrinsic time 增量和 \(B/\eta\)。
Surrogate 参数。七个参数分别是 loss floor \(L_\infty\)、forcing 项幅度 \(A_{\mathcal F}\)、噪声源幅度 \(A_0,A_1\)、memory 项的时间尺度参数 \(c_{\mathcal K}\),以及指数 \(q_{\mathcal F},q_{\mathcal K}\)。这一近似将有效响应分离为 \(K(n,s)\approx J(T_s)k(T_n-T_s)\),其中 \(J\) 是噪声源幅度,\(k\) 是传播 kernel。
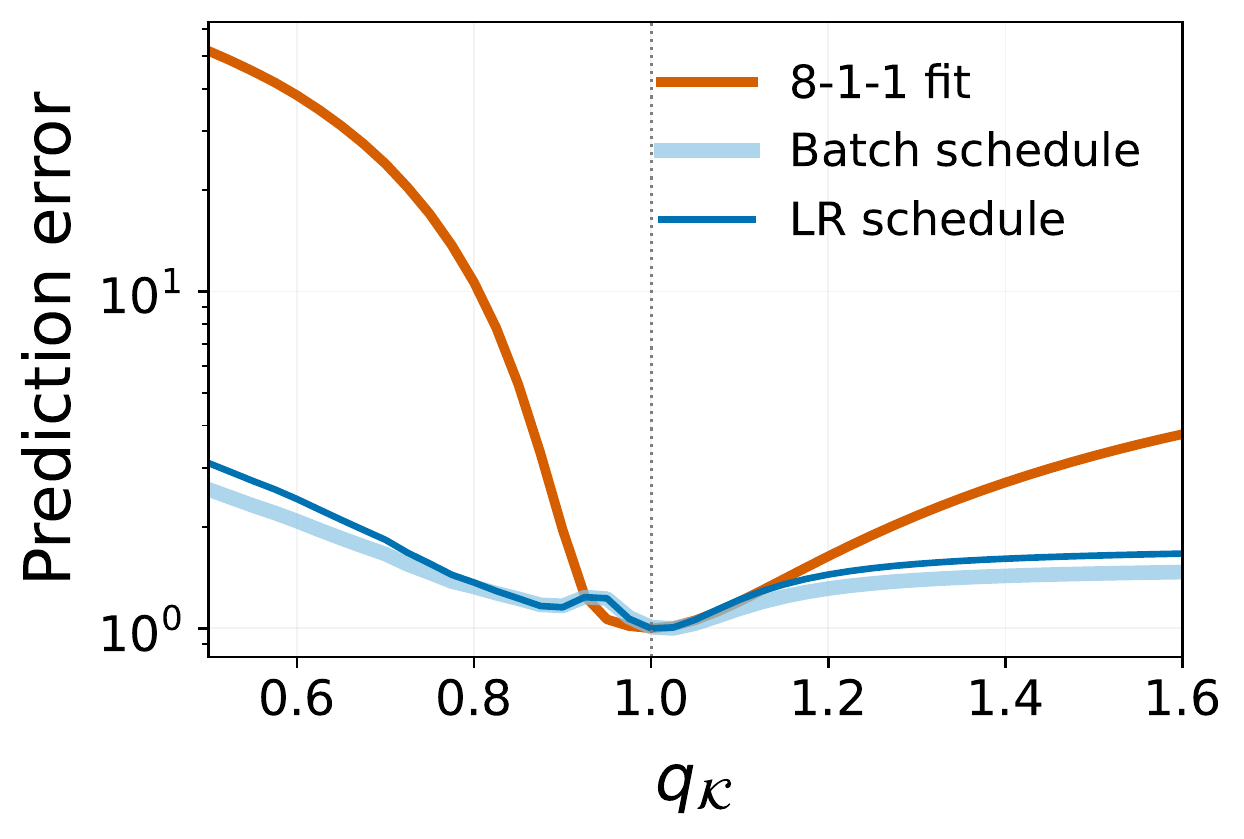
当 \(q_{\mathcal K}=1\) 时,其余六个参数只用原始、未平滑的 8-1-1 测量值拟合;拟合中没有使用任何 WSD loss。指数扫描图对每个固定指数重复这一过程,并评估由此得到的 WSD 预测误差。
Hybrid Muon。一次简短的校准为这些运行选出了不同的时钟和比值:\(\widetilde T=\sum_t\eta_t^2\) 和 \(\widetilde r=B/\eta^2\)。这些经校准的量同样使其配对曲线靠拢。
为什么 memory exponent 总是落在 1 附近?
在刚才的检验中,我们将 memory exponent 固定为 1。如果让拟合来选择它,会发生什么?
在另一些独立拟合中,我们让全部七个参数自由变化。跨越不同数据集和两种模型大小,得到的 memory exponent 都接近 1:
| 数据集与设置 | \(q_{\mathcal K}\) | \(q_{\mathcal F}\) |
|---|---|---|
| OpenWebText, 124M, 2.5B tokens | 1.017 | 0.374 |
| FineWeb sample-10BT subset, 124M, 2.5B tokens | 0.952 | 0.405 |
| peS2o V2 s2orc full text, 124M, 2.5B tokens | 0.995 | 0.365 |
| OpenWebText, 300M, 6.5B tokens | 0.989 | 0.291 |
1 正是 LM/IM 的边界:一侧的累积记忆量有限,另一侧则持续增长,而在 1 处按对数增长。这些不同任务中拟合得到的响应,都落在这条边界附近。
这些任务是否共享某种有效的记忆时间分布?还是有限的训练窗口以及拟合参数之间的权衡,将估计值拉向了同一个数值?现有曲线无法区分这些解释。改变训练时长,并测量模型对主动施加的扰动的响应,会有助于区分它们。
更广泛的启示
一条幂律曲线很容易让人误以为已经有了完整解释:拟合斜率、向外推算,故事似乎就结束了。然而,同样的形状既可能来自对剩余信号的学习,也可能来自早先噪声的持续影响。区分这些解释很重要,因为当训练发生变化时,它们意味着不同的响应。
因此,改变 schedule 不只是一个训练选择,也是探查曲线所隐藏信息的方法。如果一种解释无需重新拟合,就能跟随这次变化中的 loss 走势,它所揭示的内容便超出了原先斜率本身能告诉我们的范围。
延伸阅读
- 经验 scaling law:Kaplan et al. (2020), Scaling Laws for Neural Language Models。语言模型 loss 如何依赖模型大小、数据量和计算量。
- 谱模型:Paquette et al. (2024), 4+3 Phases of Compute-Optimal Neural Scaling Laws。一个可求解模型,将数据与目标的结构联系到计算最优的不同区域。
- Learning rate 与 batch size:Smith et al. (2018), Don’t Decay the Learning Rate, Increase the Batch Size。用增大 batch size 替代 learning rate 衰减的实验。
- 预测完整轨迹:Li et al. (2025), Functional Scaling Laws in Kernel Regression: Loss Dynamics and Learning Rate Schedules。Intrinsic time 理论,以及对 LLM 学习曲线的 surrogate 预测。
- 最优 schedule:Bordelon and Mori (2026), Theory of Optimal Learning Rate Schedules and Scaling Laws for a Random Feature Model。最优退火如何依赖谱与任务。
本文基于 From Spectra to Joint Schedules in LLM Pre-training: 3+3(+2) Scaling-Law Regimes,由 Yichen Wang、Fanghui Liu 和 Yudong Chen 合作完成。